Abbildungsvorlage · System und Netzwerk · 4:3
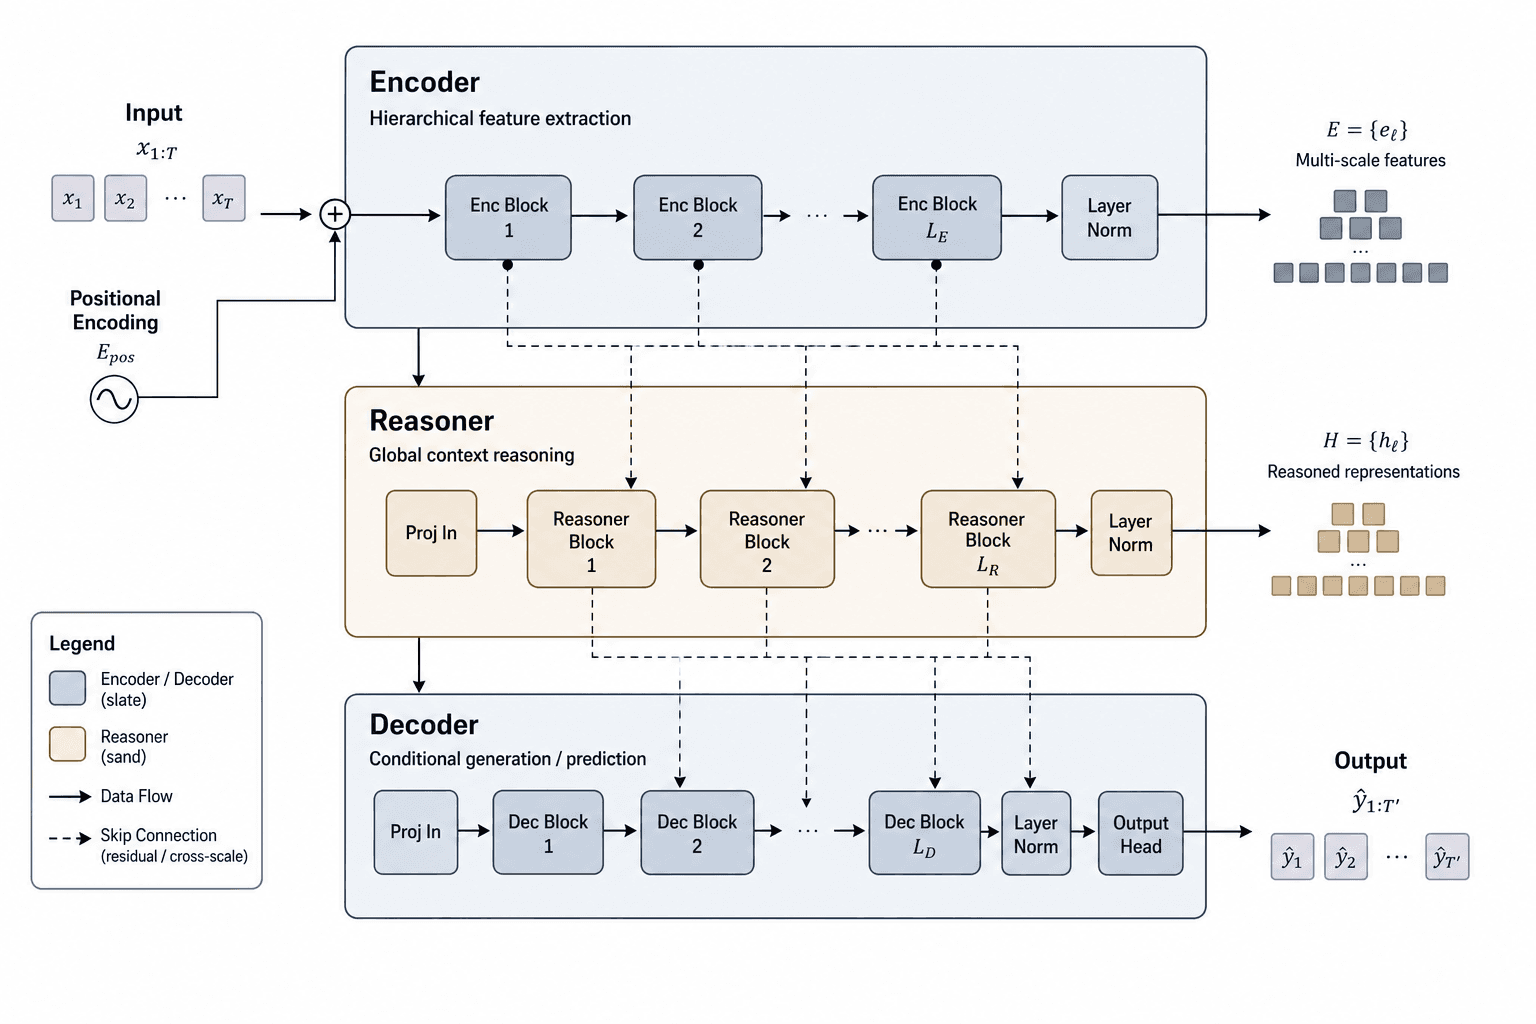
Schematische Abbildung der Transformer-Architektur
Ein Querformat mit dem gestapelten Encoder-Block oben links, zwei Panels, die Multi-Head-Attention bis zum Scaled-Dot-Product-Kern aufschlüsseln, und einem eigenen Panel für das positionsweise Feed-Forward-Netz unten rechts – passend für einen Methodenteil oder eine Vorlesung.
Prompt
Create a scientific figure about: Transformer model architecture with attention and feed-forward blocks. Visual style: Schematic Minimal. Requirements: - publication-ready scientific quality - clear labels and directional arrows where appropriate - avoid cartoon style, avoid meme style, avoid stock-photo look - avoid neon glow and over-sharpened CGI look unless explicitly requested - composition optimized for research papers and academic slides - category context: systems-networks - minimal schematic style with reduced visual noise - strong information hierarchy using line weight and spacing - few but meaningful colors for process emphasis
Was diese Vorlage ist
Die Abbildung führt vom Ganzen zum Detail. Der Encoder-Block oben links beginnt dort, wo das Input-Embedding auf das Positional Encoding trifft, und durchläuft Multi-Head-Self-Attention, einen Add-&-Norm-Knoten und das Feed-Forward-Netz; ein Kartenstapel markiert die Wiederholung. Die Attention-Panels öffnen diesen Block: Queries, Keys und Values erhalten jeweils eine eigene lineare Projektion und münden in den Scaled-Dot-Product-Kern aus Matrixmultiplikation, Skalierung, optionaler Maske und Normierung; danach werden die Köpfe verkettet und erneut projiziert. Unten rechts zerfällt das Feed-Forward-Netz in zwei lineare Schichten um eine einzige Aktivierung. Die Hierarchie entsteht über Strichstärke und eine kleine Farbpalette.
Zu beschriftende Elemente
Encoder-Block
Embedding, Attention, Add & Norm und Feed-Forward von unten nach oben gestapelt; das Wiederholungszeichen sitzt in der oberen Ecke des Blocks.
Einspeisung des Positional Encoding
Das Positional Encoding trifft an einem eingekreisten Summenzeichen auf das Input-Embedding; der Pfeil zeigt nach oben in den Block hinein.
Residualverbindungen
Linien, die jede Teilschicht bis zu ihrem Add-Knoten überbrücken, in einem Strichstil, den die Legende getrennt vom Hauptstrang benennt.
Multi-Head-Panel
Versetzte Karten stehen für die einzelnen Köpfe; die erste und die letzte Karte sind an den beiden Enden des Stapels beschriftet.
Projektionen für Query, Key und Value
Drei lineare Projektionen nebeneinander, jede mit eigener Gewichtsmatrix und dem zugehörigen Dimensionssymbol.
Scaled-Dot-Product-Kern
Matrixmultiplikation, Skalierung, optionale Maske und Normierung in einer Spalte, abgeschlossen durch das Produkt mit den Values.
Verkettung und Projektion
Die Ausgaben der Köpfe werden zu einem Tensor zusammengeführt, gefolgt von einer letzten linearen Schicht mit der Modelldimension als Beschriftung.
Feed-Forward-Panel
Zwei lineare Schichten um eine einzige Aktivierung; die möglichen Aktivierungsfunktionen stehen in Klammern neben dem Kasten.
Wofür sie verwendet wird
- Mechanismusabbildung im Paper
- Vorlesungsunterlagen
- Folien zur Verteidigung
- Website der Arbeitsgruppe
Worauf Gutachter achten
Position der Normierung festlegen
Normierung nach der Teilschicht und Normierung davor sind beide verbreitet. Was das Schema zeigt, muss zu Ihrem Code passen – sonst baut jeder, der das Modell anhand der Abbildung nachbaut, den falschen Block.
Die Maske ist kein Automatismus
Self-Attention im Encoder trägt in der Regel keine kausale Maske. Erscheint der optionale Maskenkasten im Kern, vermerken Sie, dass er zum Decoder oder zum Padding gehört und nicht in jeder Schicht künftige Positionen verdeckt.
Dimensionen konsistent halten
Die Symbole an den Projektionen, an der Verkettung und an der Ausgabeschicht müssen zusammenpassen: Anzahl der Köpfe mal Breite pro Kopf ergibt die Modelldimension – ein Zusammenhang, der in die Legende gehört.
Benennen, was fehlt
Aufgeschlüsselt ist nur die Encoder-Seite. Ergänzen Sie für ein Encoder-Decoder-Modell den Decoder samt Cross-Attention, oder schreiben Sie in die Bildunterschrift ausdrücklich, dass nur der Encoder dargestellt ist.
So verwenden Sie die Vorlage in Yila
- 1Abbildung auswählen
- 2Forschungsgegenstand und zu betonende Schritte beschreiben
- 3Im Chat weiter verfeinern und dann als PNG herunterladen
Tipps
Empfehlenswert
- Geben Sie im Prompt Ihre tatsächliche Schichtzahl, Kopfzahl und versteckte Breite an, damit Stapelzeichen und Dimensionsangaben echte Werte tragen.
- Wünschen Sie eine einzige Akzentfarbe für den Attention-Pfad und Grau für den Rest; ein minimalistisches Schema trennt Ebenen über die Strichstärke.
Besser vermeiden
- Behalten Sie nicht zwei fast gleiche Attention-Panels in einer Abbildung; wählen Sie das vollständigere und lassen Sie das andere entfernen.
- Häufen Sie keine Beschriftungen an den Pfeilen an: Das Layout lebt vom Weißraum, und gedrängte Schrift ebnet die Hierarchie schnell ein.
Häufige Fragen
Kann ich die Abbildung direkt in einem Paper verwenden?
Verstehen Sie sie als Entwurf für den Methodenteil. Es handelt sich um ein KI-generiertes Rasterbild; prüfen Sie daher die Schreibweise in jedem Kasten, die Richtung jedes Pfeils und die Dimensionssymbole gegen Ihren Code, und lassen Sie doppelte oder überzählige Panels im Chat entfernen, bevor Sie die Abbildung als fertig betrachten.
Lassen sich einzelne Elemente der Abbildung ändern?
Nicht Element für Element, wohl aber im Chat mit Yila: den Decoder mit Cross-Attention ergänzen, die Normierung vor jede Teilschicht ziehen, den Maskenkasten streichen oder nur den Encoder-Block behalten. Aus dieser Beschreibung entsteht dann eine neue Version.
In welchem Format erhalte ich das Ergebnis?
Als KI-generiertes PNG im Querformat, geeignet für eine Methodenabbildung, ein Vorlesungsskript oder eine Verteidigungsfolie. Eine Vektorgrafik ist es nicht; die kleine Schrift in den Kästen wird beim Verkleinern weicher und sollte in Einreichungsgröße geprüft werden.
Ist die Nutzung kostenlos?
Das Durchsehen dieser Seite und des Beispielbilds kostet nichts. Eine eigene Version in Yila verbraucht Credits; neue Konten erhalten 2.500 Credits, genug, um Tiefe, Attention-Panels und Feed-Forward-Block über mehrere Runden anzupassen.
Ich arbeite an Vision-Modellen. Lässt sich das übertragen?
Ja. Attention und Feed-Forward behalten ihre Form; beschreiben Sie die Eingabe als Patch-Embeddings, verlangen Sie das zu Ihrem Aufbau passende Positional Encoding und ergänzen Sie den Klassifikationskopf oder den Decodierpfad außerhalb des Blocks.
Geht auch nur der Encoder-Block?
Fordern Sie den Block oben links allein an, ohne die Panels für Attention und Feed-Forward. Das schmale Ergebnis passt in eine Ecke einer Folie oder eines Handouts, wenn die Details ohnehin im Text erklärt werden.