Abbildungsvorlage · System und Netzwerk · 4:3
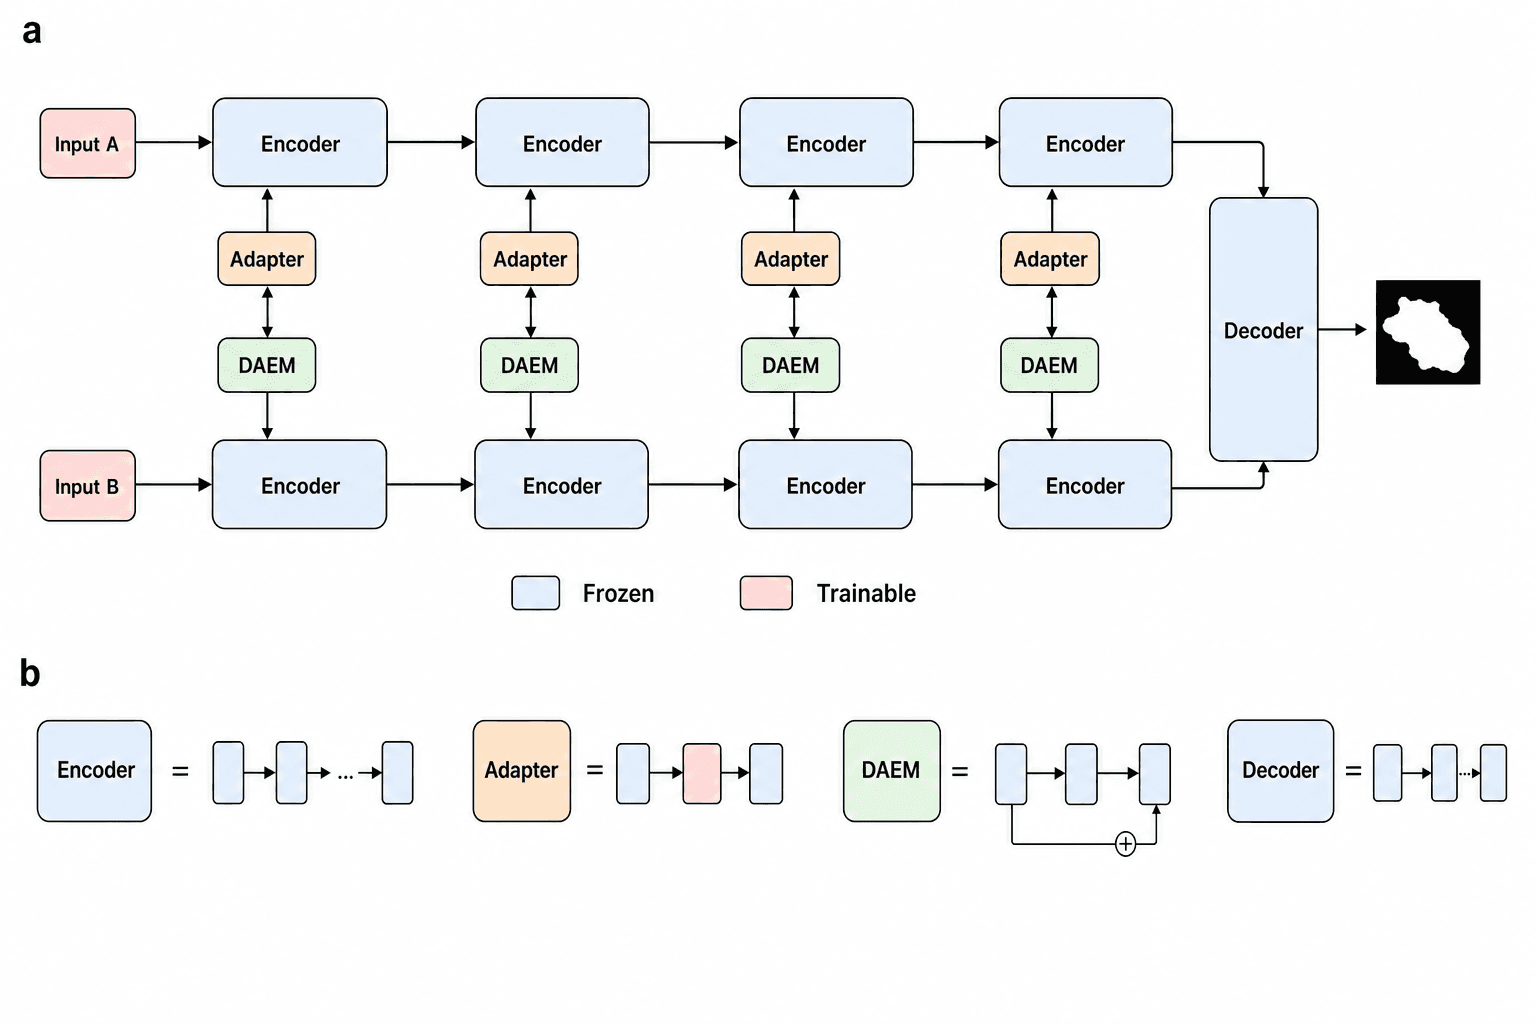
Dual-Stream-Encoder mit Adaptermodulen und Decoder-Maske
Zwei parallele Encoder-Pfade laufen von links nach rechts, zwischen ihnen sitzt auf jeder Stufe ein Adapter- und ein Fusionsblock, und beide münden in einen Decoder, der eine Segmentierungsmaske ausgibt; ein unteres Feld zerlegt jedes Modul – gedacht als Übersichtsabbildung im Methodenteil.
Prompt
Create a scientific figure about: Dual-stream encoder with adapter blocks and a decoder mask. Visual style: Clean Vector. Requirements: publication-ready scientific quality, clear labels and directional arrows where appropriate, avoid cartoon or stock-photo look, composition optimized for research papers and academic slides.
Was diese Vorlage ist
Teilabbildung a zeigt den Datenfluss: Eingabe A und Eingabe B durchlaufen jeweils eine Kette von vier als eingefroren markierten Encoder-Stufen. Auf jeder Stufe stehen zwischen den beiden Strömen ein Adapter und ein mit DAEM beschrifteter Fusionsblock, sodass die Merkmale Schicht für Schicht ausgetauscht werden. Die letzte Stufe beider Ströme speist einen hohen Decoder, der eine weiße Binärmaske auf schwarzem Grund liefert. Teilabbildung b schreibt Encoder, Adapter, Fusionsblock und Decoder mit Gleichheitszeichen als kurze Folgen kleiner Blöcke aus, im Fusionsblock einschließlich einer Residualsumme. Wer die Abbildung liest, soll erkennen, welche Parameter trainiert werden und wo sich die beiden Ströme treffen.
Zu beschriftende Elemente
Zwei Eingaben
Kleine Kästen für Eingabe A und Eingabe B am linken Rand; in der fertigen Abbildung nennen Sie die tatsächlichen Modalitäten, etwa RGB und Tiefe.
Encoder-Stufen
Gleich breite Kästen je Strom, verbunden durch waagerechte Pfeile; tragen Sie die Merkmalsauflösung jeder Stufe direkt in den Kasten ein.
Adaptermodule
Orangefarbene Kästen, die nach oben in den ersten Strom einspeisen; laut Teilabbildung b ist nur ihre mittlere Schicht trainierbar.
DAEM-Fusionsblöcke
Grüne Kästen, die nach unten in den zweiten Strom einspeisen; Abkürzung und Funktion gehören ausgeschrieben in die Bildunterschrift.
Decoder
Ein hoher Kasten rechts, der die Endausgabe beider Ströme aufnimmt; die Pfeile treten von oben und von unten ein.
Binärmaske
Eine weiße Fläche auf Schwarz als Segmentierungsergebnis; daneben gehören die Vorhersageaufgabe und die Ausgabeauflösung.
Legende eingefroren/trainierbar
Blau steht für eingefroren, Rosa für trainierbar; jede weitere Farbe der Abbildung muss ebenfalls in diese Legende.
Modulzerlegung
Jedes Modul, gefolgt von einem Gleichheitszeichen und einer Reihe kleiner Blöcke; unter dem Fusionsblock ist eine Residualsumme gezeichnet.
Wofür sie verwendet wird
- Mechanismusabbildung im Paper
- Folien zur Verteidigung
- Wissenschaftliches Poster
- Vorlesungsunterlagen
Worauf Gutachter achten
Farben passen nicht zur Trainierbarkeit
Die Legende kennt zwei Farben, doch die Eingaben sind rosa, Adapter und Fusionsblöcke tragen Orange und Grün außerhalb der Legende, und der Decoder gilt als eingefroren. Gutachter werden genau fragen, welche Parameter trainiert werden.
Ist die Fusion symmetrisch?
Adapter speisen nur in den oberen, Fusionsblöcke nur in den unteren Strom ein, verbunden durch einen Doppelpfeil. Erklären Sie, ob diese Asymmetrie gewollt ist, sonst vermuten Leser eine vergessene Richtung.
Keine Skip-Verbindungen zum Decoder
Segmentierungsdecoder greifen meist auf mehrere Encoder-Stufen zurück, hier erhält der Decoder nur die letzte. Nutzt Ihr Modell Merkmale auf mehreren Skalen, ergänzen Sie die Verbindungen und kennzeichnen Sie das Upsampling je Ebene.
Abkürzungen und Stufendetails
DAEM wird nirgends ausgeschrieben, und die Stufen nennen keine Auflösung. Die Bildunterschrift sollte den vollen Modulnamen sowie Kanalzahlen oder Downsampling-Faktoren angeben, damit sich das Netz anhand der Abbildung nachbauen lässt.
So verwenden Sie die Vorlage in Yila
- 1Abbildung auswählen
- 2Forschungsgegenstand und zu betonende Schritte beschreiben
- 3Im Chat weiter verfeinern und dann als PNG herunterladen
Tipps
Empfehlenswert
- Legen Sie im Prompt fest, welche Module eingefroren und welche trainiert werden, damit die Legende Ihrem tatsächlichen Trainingsaufbau entspricht.
- Ersetzen Sie Eingabe A und B durch die echten Modalitäten, damit ohne Fließtext klar ist, was jeder Strom verarbeitet.
- Schreiben Sie Merkmalskartengröße oder Downsampling-Faktor jeder Stufe in den Prompt, dann ist die Hierarchie der Encoder-Kette sofort sichtbar.
Besser vermeiden
- Lassen Sie keine Farbe unerklärt stehen; jede zusätzliche Farbe braucht eine Bedeutung in der Legende.
- Packen Sie keine Schichtnamen und Parameter in die kleinen Blöcke von Teilabbildung b, im Druck bleiben davon nur Farbflecken.
Häufige Fragen
Kann ich die Architekturabbildung direkt im Paper verwenden?
Sie taugt als erster Entwurf der Übersichtsabbildung. Da es sich um ein KI-generiertes Rasterbild handelt, prüfen Sie die Zuordnung von Farben zu Trainierbarkeit, die Modulabkürzungen und jede Pfeilrichtung anhand Ihres Codes, bevor Sie über die Einreichung entscheiden; korrigieren Sie zuerst die Legende.
Lassen sich Module in der Abbildung ändern?
Nicht Element für Element, aber im weiteren Chat mit Yila: drei statt vier Encoder-Stufen, Skip-Verbindungen zum Decoder, Cross-Attention anstelle des Fusionsblocks oder eine Legende mit vier Farben. Aus dieser Beschreibung entsteht dann eine neue Version.
In welchem Format erhalte ich die Abbildung?
Als KI-generiertes PNG im Querformat 4:3 mit einem oberen und einem unteren Feld. Eine Vektorgrafik ist es nicht, und die winzigen Blöcke und Auslassungspunkte in Teilabbildung b verschwimmen beim Verkleinern; sehen Sie sich das Bild daher in der echten Breite einer zweispaltigen Seite an.
Ist das kostenlos?
Diese Seite und das Beispiel anzusehen kostet nichts. Eine eigene Architekturabbildung in Yila verbraucht Credits; neue Konten erhalten 2.500 Credits und können damit mehrere Modulanordnungen und Farbschemata ausprobieren, bevor sie eines für das Paper auswählen.
Mein Modell hat nur einen Eingabestrom. Lässt sich die Vorlage anpassen?
Ja. Bitten Sie darum, den unteren Pfad zu entfernen, neben jeder Stufe einen Adapter als Baustein für parameter-effizientes Fine-Tuning zu belassen und den Decoder an den einzelnen Strom anzuschließen; die Modulzerlegung in Teilabbildung b bleibt unverändert.
Kann der Decoder ausführlicher dargestellt werden?
Verlangen Sie im Chat, den Decoder in Upsampling-Stufen mit Skip-Verbindungen aus den passenden Encoder-Stufen aufzuteilen. Die Abbildung wird dadurch breiter; kürzen Sie Teilabbildung b am besten auf die neuen oder geänderten Module und halten Sie die Legende bei neuen Farben auf dem gleichen Stand.