Abbildungsvorlage · Arbeitsablauf · 4:3
Verzweigter Analyse-Workflow am Beispiel Einzelzell-RNA-seq
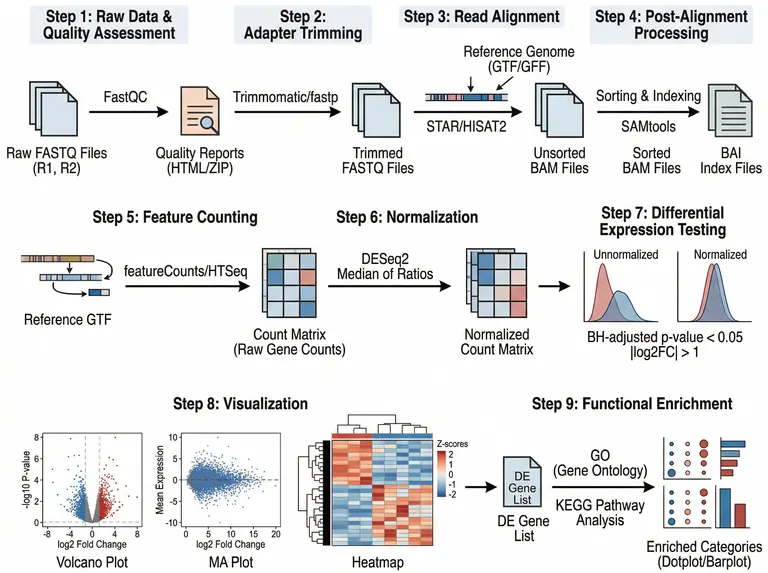
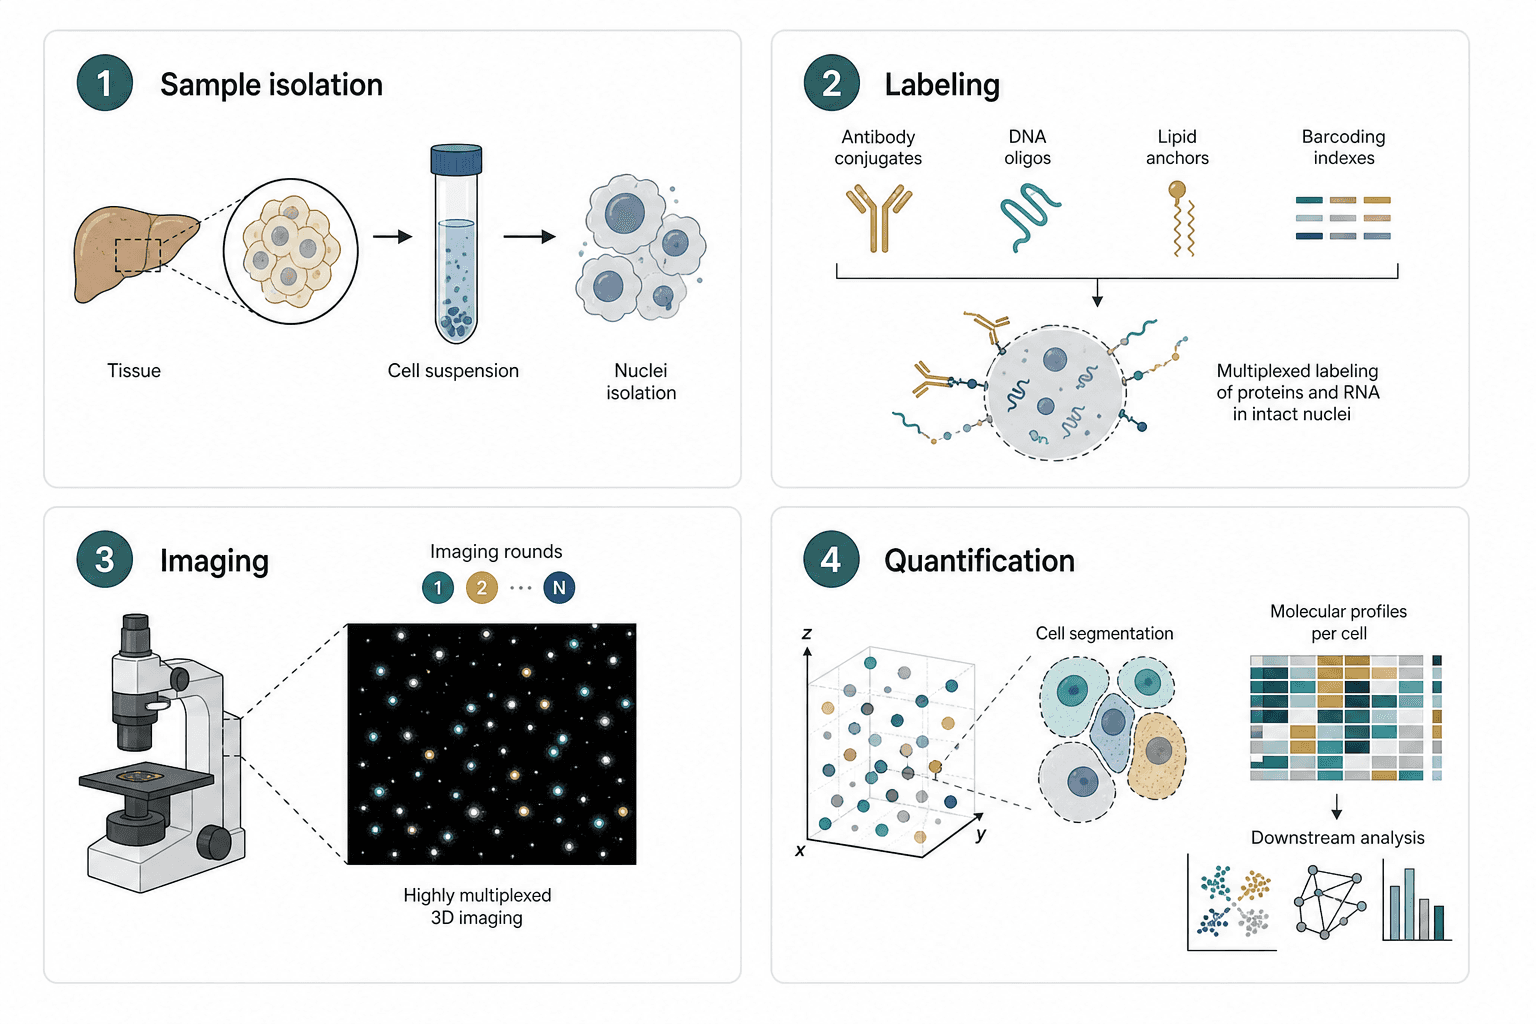
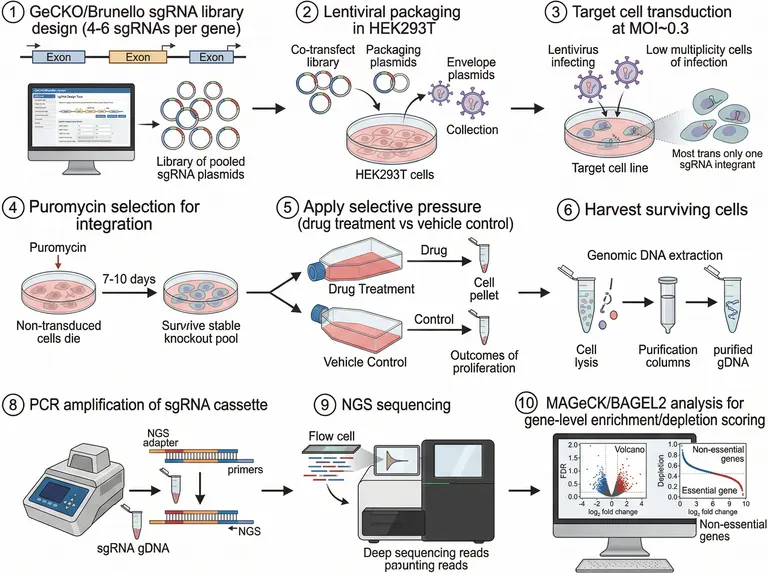
Eine Abbildung mit neun Panels, die einen verzweigten Analyse-Workflow an einem Einzelzell-RNA-seq-Experiment vorführt: Die Reads teilen sich in zwei Zweige und treffen sich in einer Count-Matrix wieder. Modellvergleich und Validierung müssen Sie für Ihre eigene Studie ergänzen.
Prompt
Create a scientific figure about: Branching analysis workflow with ingestion, preprocessing, model comparison, validation, and reporting. Visual style: Clean Vector. Requirements: publication-ready scientific quality, clear labels and directional arrows where appropriate, avoid cartoon or stock-photo look, composition optimized for research papers and academic slides.
Was diese Vorlage ist
Die ersten sechs Panels zeigen Laborarbeit: Gewebe wird zu Einzelzellen dissoziiert, mit Barcode-Gel-Beads in Öltröpfchen verteilt und revers transkribiert, sodass jedes Transkript einen Zell-Barcode und eine UMI trägt; danach folgen Amplifikation, Library-Bau und Sequenzierung. Die letzten drei sind Rechenarbeit: Aligned Reads verzweigen sich in Demultiplexing pro Zelle und UMI-Deduplizierung, vereinen sich zu einer Gen-mal-Zelle-Count-Matrix und durchlaufen QC-Filterung, Normalisierung, Auswahl variabler Gene, Clustering und eine UMAP-Darstellung. Erkennbar werden soll, wo sich die Daten gabeln, wo sie zusammenlaufen und welchen Beitrag jeder Zweig zur Matrix leistet, von der alle weiteren Schritte abhängen.
Zu beschriftende Elemente
Dateneingang
Rohe Read-Dateien betreten die rechnerische Hälfte; der Pfeil läuft vom Sequenzierpanel direkt ins Alignment und ist als unverarbeitete Reads beschriftet.
Verzweigungspunkt
Nach dem Alignment teilen sich die Reads in Demultiplexing pro Zelle und UMI-Deduplizierung; beide Pfeile laufen sichtbar an der Count-Matrix wieder zusammen.
Count-Matrix
Ein Gitter aus Genen und Zellen am Zusammenführungspunkt, daneben die Bedeutung von Zeilen und Spalten, damit niemand Proben darin liest.
Kontrollpunkt QC-Filterung
Nennen Sie die Filterkriterien, etwa detektierte Gene pro Zelle und mitochondrialen Anteil, als Schranke, die Zellen vor den Folgeschritten passieren müssen.
Normalisierung
Auf die Filterung folgt die Normalisierung mit dem Hinweis, dass sie Unterschiede in der Sequenziertiefe ausgleicht; sie führt zur Auswahl variabler Gene.
Merkmalsauswahl
Die Auswahl variabler Gene erhält einen eigenen Kasten mit der Angabe, dass Clustering und Embedding nur diese Gene verwenden.
Ergebnisdarstellung
Jedes Cluster auf der UMAP genau einmal nummerieren; im Beispiel tragen zwei verschiedene Cluster die Bezeichnung Cluster 3.
Wofür sie verwendet wird
- Mechanismusabbildung im Paper
- Vorlesungsunterlagen
- Folien zur Verteidigung
- Website der Arbeitsgruppe
Worauf Gutachter achten
Vergleich und Validierung fehlen
Die im Auftrag dieser Vorlage genannten Kontrollpunkte für Modellvergleich und Validierung tauchen im Beispiel nicht auf; es endet bei einem Cluster-Plot. Ergänzen Sie einen Vergleichszweig und einen unabhängigen Validierungsknoten, wenn Ihr Paper Auflösung oder Annotation begründen muss.
Zwei Panels mit gleichem Titel
Das dritte und das vierte Panel tragen denselben Titel zur reversen Transkription, sodass Gutachter einen fehlenden Schritt vermuten. Benennen Sie das dritte in Zelllyse im Tröpfchen um oder fassen Sie beide zu einem Panel zusammen, damit die Nummerierung lückenlos bleibt.
Cluster-Beschriftungen müssen übereinstimmen
Zwei Cluster in unterschiedlichen Farben heißen beide Cluster 3. Clusternummern, Farben und die Zelltyp-Annotation im Text müssen eins zu eins zusammenpassen, bevor ein Vergleich zwischen Clustern für Lesende Sinn ergibt.
Barcode und UMI unterscheiden
Der Zell-Barcode identifiziert die Zelle, die UMI entfernt Amplifikationsduplikate; das Library-Schema sollte beide getrennt beschriften. Das Beispiel trifft das im Großen und Ganzen; halten Sie die beiden beim Bearbeiten auf getrennt eingefärbten Segmenten.
So verwenden Sie die Vorlage in Yila
- 1Abbildung auswählen
- 2Forschungsgegenstand und zu betonende Schritte beschreiben
- 3Im Chat weiter verfeinern und dann als PNG herunterladen
Tipps
Empfehlenswert
- Nennen Sie im Prompt die verglichenen Methoden und Ihre Validierung, damit nach dem Clustering ein paralleler Zweig und ein Validierungskasten erscheinen.
- Zeigen Sie nur die Rechenschritte, lassen Sie die sechs Laborpanels streichen und geben Sie Verzweigung und Zusammenführung die volle Breite.
- Geben Sie jedem Zweig eine eigene Farbe und mischen Sie beide an der Zusammenführung, damit nachvollziehbar bleibt, welche Daten wohin gingen.
Besser vermeiden
- Übernehmen Sie keine Plattform-, Software- oder Sequenzermarken aus dem Beispiel; beschreiben Sie jeden Schritt über seine Funktion.
- Lassen Sie keine Clusternummer doppelt stehen; prüfen Sie nach jeder Erzeugung alle Beschriftungen im Embedding-Plot.
- Zeichnen Sie den Validierungsknoten nicht auf denselben Zweig wie das Training; er sollte zurückgehaltene Daten erhalten, damit seine Unabhängigkeit sichtbar ist.
Häufige Fragen
Kann die Abbildung ohne Änderungen ins Paper?
Betrachten Sie sie als ersten Entwurf eines Methodenschemas. Es ist ein KI-generiertes PNG, und das Beispiel wiederholt einen Paneltitel, vergibt eine Clusternummer doppelt und enthält einen Schreibfehler. Prüfen Sie jedes Panel und verfeinern Sie die Abbildung im Chat, bis sie zum Layout der Zeitschrift passt.
Lassen sich Elemente der Abbildung ändern?
Nicht Element für Element, aber im Gespräch mit Yila: Einzelzelldaten durch Ihren eigenen Datentyp ersetzen, einen Zweig für den Modellvergleich und einen Validierungsknoten hinzufügen oder die Laborpanels entfernen; anschließend wird eine neue Version erzeugt.
Was für eine Datei erhalte ich?
Ein KI-generiertes PNG im Querformat, bereit für Paper oder Folie. Es ist keine Vektorgrafik, und die neun Panels enthalten viel kleine Schrift; prüfen Sie die Beschriftungen, bevor Sie es auf eine halbe Spalte verkleinern.
Muss ich dafür bezahlen?
Seite und Beispiel durchzusehen kostet nichts. Das Erzeugen in Yila verbraucht Credits; neue Konten erhalten 2.500 Credits, ausreichend, um die Pipeline über mehrere Runden an Ihre Daten, Verzweigungsstruktur und Validierung anzupassen, einschließlich einer gekürzten Fassung für Folien.
Meine Analyse kommt ohne Laborarbeit aus. Passt das trotzdem?
Ja. Der Kern eines verzweigten Workflows sind Dateneingang, Vorverarbeitung, Merkmalsauswahl, Vergleich, Validierung und Berichterstattung. Beschreiben Sie nur die Rechenschritte und die verglichenen Modelle; die Laborpanels entfallen, und die Gabelung wird deutlich gezeichnet.
Was, wenn ich mehr als zwei Zweige habe?
Führen Sie im Prompt jeden Zweig und seinen Zusammenführungspunkt auf, zum Beispiel drei parallel laufende Normalisierungsmethoden vor einem Vergleich der Clusterstabilität. Die Zweige werden dann als parallele Reihen gestapelt und mit einer gemeinsamen Umrandung am Vergleichsknoten gesammelt.