Modèle de figure · Schéma de processus · 4:3
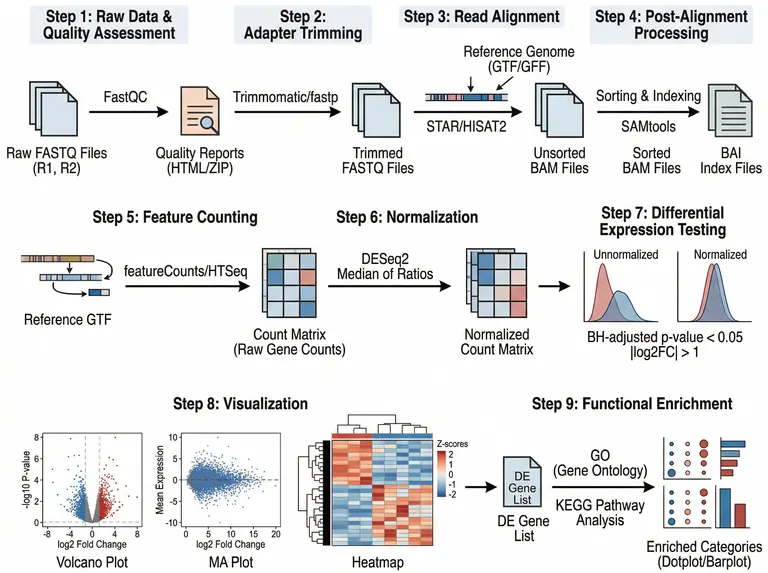
Pipeline d’analyse RNA-seq bulk : de l’expression différentielle à l’enrichissement
Une figure sur trois rangées qui conduit des données RNA-seq bulk, des lectures brutes pair-end jusqu’à la liste de gènes différentiellement exprimés et à l’enrichissement fonctionnel ; dimensionnée pour un panneau de méthodes en transcriptomique, une soutenance ou un cours de bio-informatique.
Prompt
Create a scientific figure about: Bulk RNA-seq differential expression workflow with QC, alignment, quantification, DE testing, and enrichment. Visual style: Clean Vector. Requirements: publication-ready scientific quality, clear labels and directional arrows where appropriate, avoid cartoon or stock-photo look, composition optimized for research papers and academic slides.
Ce qu’est ce modèle
La figure déroule en neuf étapes la chaîne standard du RNA-seq bulk. Les lectures brutes passent un contrôle qualité et un retrait des adaptateurs, sont alignées sur un génome de référence, triées et indexées, puis comptées sur une annotation de gènes pour former une matrice de comptages bruts. Ces comptages sont normalisés selon la taille des banques, soumis à un test d’expression différentielle et représentés en volcano plot, MA plot et heatmap, avant que la liste de gènes ne parte vers l’enrichissement GO et KEGG. Le lecteur doit retenir quelle étape produit quel fichier et à quel moment interviennent les statistiques.
Éléments à légender
Contrôle qualité des lectures
Les fichiers de lectures pair-end à gauche, le rapport qualité à côté, avec une légende indiquant que les deux mates sont contrôlés.
Retrait des adaptateurs
Écrivez sur la flèche ce qui est retiré, et teintez les fichiers nettoyés autrement que les fichiers bruts pour rendre le changement visible.
Alignement
Représentez le génome de référence comme un fichier de séquence et donnez à l’annotation sa propre étiquette au lieu de les confondre.
Comptage par gène
Reliez le comptage à la fois aux lectures alignées et à l’annotation, et nommez la sortie matrice de comptages bruts.
Normalisation
Nommez la méthode de normalisation et utilisez une même échelle de couleurs pour les matrices avant et après, afin de les comparer directement.
Test d’expression différentielle
Ce panneau doit porter le test et le seuil de correction pour tests multiples, pas des courbes de densité de comptages normalisés.
Graphiques de résultats
Le volcano plot met le log fold change en abscisse ; le MA plot met l’expression moyenne en abscisse et le log fold change en ordonnée.
Enrichissement fonctionnel
Faites partir la liste de gènes différentiels vers deux branches GO et KEGG, et affichez les catégories enrichies en dot plot ou en barres.
Où on l’utilise
- Figure de mécanisme pour article
- Diapositives de soutenance
- Support de cours
- Poster scientifique
Ce que vérifient les évaluateurs
Axes du MA plot inversés
Dans l’exemple, le MA plot place l’expression moyenne en ordonnée et le log fold change en abscisse, à rebours de la convention M contre A qu’attendent les évaluateurs ; permutez les intitulés d’axes avant toute utilisation.
La septième étape montre autre chose
Le panneau d’expression différentielle dessine des courbes de densité normalisées et non normalisées au lieu d’un test. Remplacez-les par le seuil de significativité, la méthode de correction et le nombre de gènes surexprimés et sous-exprimés.
L’annotation n’est pas le génome
L’exemple légende le GTF comme génome de référence, alors qu’un GTF est une annotation de gènes. L’alignement utilise la séquence du génome, le comptage utilise l’annotation : ces deux entrées doivent porter des étiquettes distinctes.
Réplicats et lots
Les évaluateurs demandent combien de réplicats biologiques compte chaque groupe et si l’effet de lot a été modélisé. Si votre figure est un pipeline linéaire, ajoutez près de la matrice une courte note de plan expérimental : groupes, réplicats, terme de lot.
Comment l’utiliser dans Yila
- 1Choisissez une figure
- 2Décrivez votre sujet et les étapes à mettre en avant
- 3Affinez-la dans la conversation, puis téléchargez le PNG
Conseils
À faire
- Nommez dans le prompt votre véritable voie de quantification, par exemple le pseudo-alignement au niveau des transcrits, pour que les fichiers intermédiaires changent en conséquence.
- Pour un emplacement en demi-colonne, demandez de replier les trois rangées en deux et d’omettre les petites étapes comme le tri et l’indexation.
- Pour mettre l’accent sur les statistiques, faites agrandir le panneau du test et inscrire le modèle, la méthode de correction et le seuil retenus.
À éviter
- Conserver les noms d’outils et les seuils imprimés dans l’exemple ; remplacez-les par les logiciels et les valeurs seuils que rapporte votre section de méthodes.
- Faire passer le volcano plot et la heatmap de l’exemple pour vos résultats ; remplacez-les par de vrais graphiques ou indiquez clairement qu’ils sont schématiques.
- Laisser des flèches revenir du tri vers l’alignement ; chaque flèche doit avancer, des lectures brutes jusqu’à l’enrichissement.
Questions fréquentes
Puis-je reprendre ce schéma directement dans mon article ?
C’est un bon point de départ pour un schéma de méthodes. Il s’agit d’un PNG généré par IA, et l’exemple présente des axes de MA plot inversés et un panneau de test qui montre des distributions : vérifiez chaque étape au regard de votre pipeline et poursuivez les retouches dans la conversation jusqu’à satisfaire les exigences de la revue.
Puis-je modifier les étapes ou les noms d’outils ?
Pas élément par élément, mais la conversation avec Yila permet de continuer à l’ajuster : supprimer le trimming, passer au pseudo-alignement, ajouter une correction de lot ou retirer la branche KEGG, puis demander une nouvelle version intégrant ces changements.
Quel est le format livré ?
Une image PNG générée par IA, prête pour un article, un support de cours ou une diapositive. Ce n’est pas une image vectorielle, et les petites étiquettes du volcano plot, du MA plot et de la heatmap peuvent devenir floues en réduction : prévisualisez-la à la largeur de colonne finale avant soumission.
L’utilisation est-elle gratuite ?
Consulter cette page et l’exemple ne coûte rien. La génération dans Yila consomme des crédits, et chaque nouveau compte reçoit 2 500 crédits, suffisamment pour reconstruire ce pipeline autour de votre aligneur, de votre méthode de comptage et de vos bases d’enrichissement en plusieurs allers-retours.
Je travaille sur des données single-cell. La figure convient-elle ?
Elle est conçue pour le RNA-seq bulk, où le test repose sur des comptages par échantillon. Le single-cell ajoute le démultiplexage des barcodes, le clustering et l’annotation des types cellulaires : décrivez un pipeline single-cell dans le prompt et laissez la figure réorganiser les étapes.
La rangée des graphiques peut-elle montrer mes vrais résultats ?
Vous pouvez préciser le style du volcano plot, du MA plot et de la heatmap, mais les points d’une figure générée sont illustratifs et ne portent aucune donnée. Placez vos graphiques réels dans la section résultats et gardez cette rangée comme emplacements légendés du flux de travail.