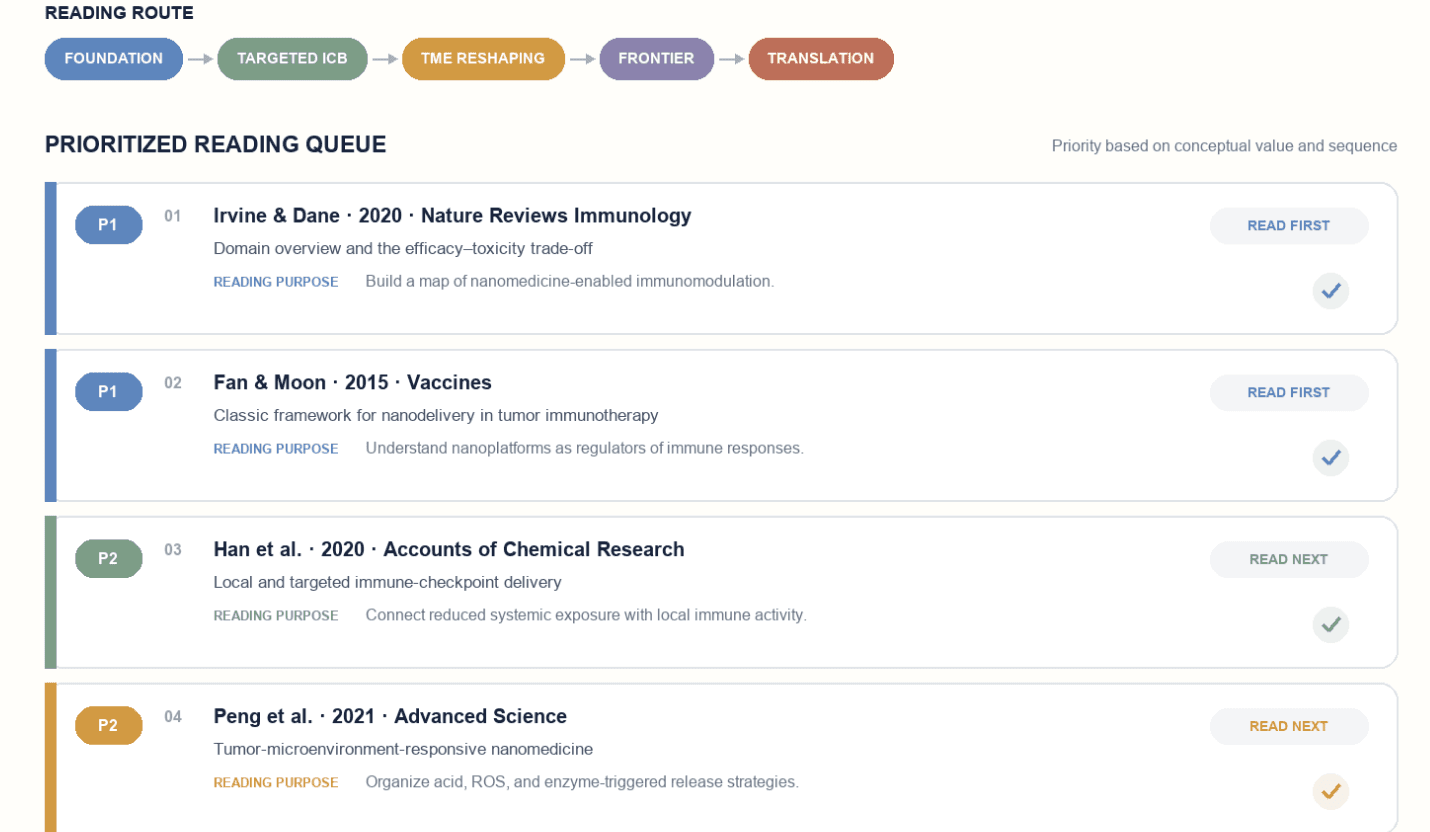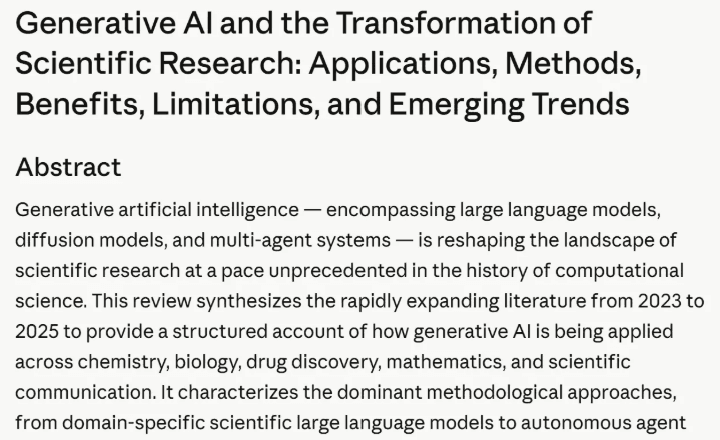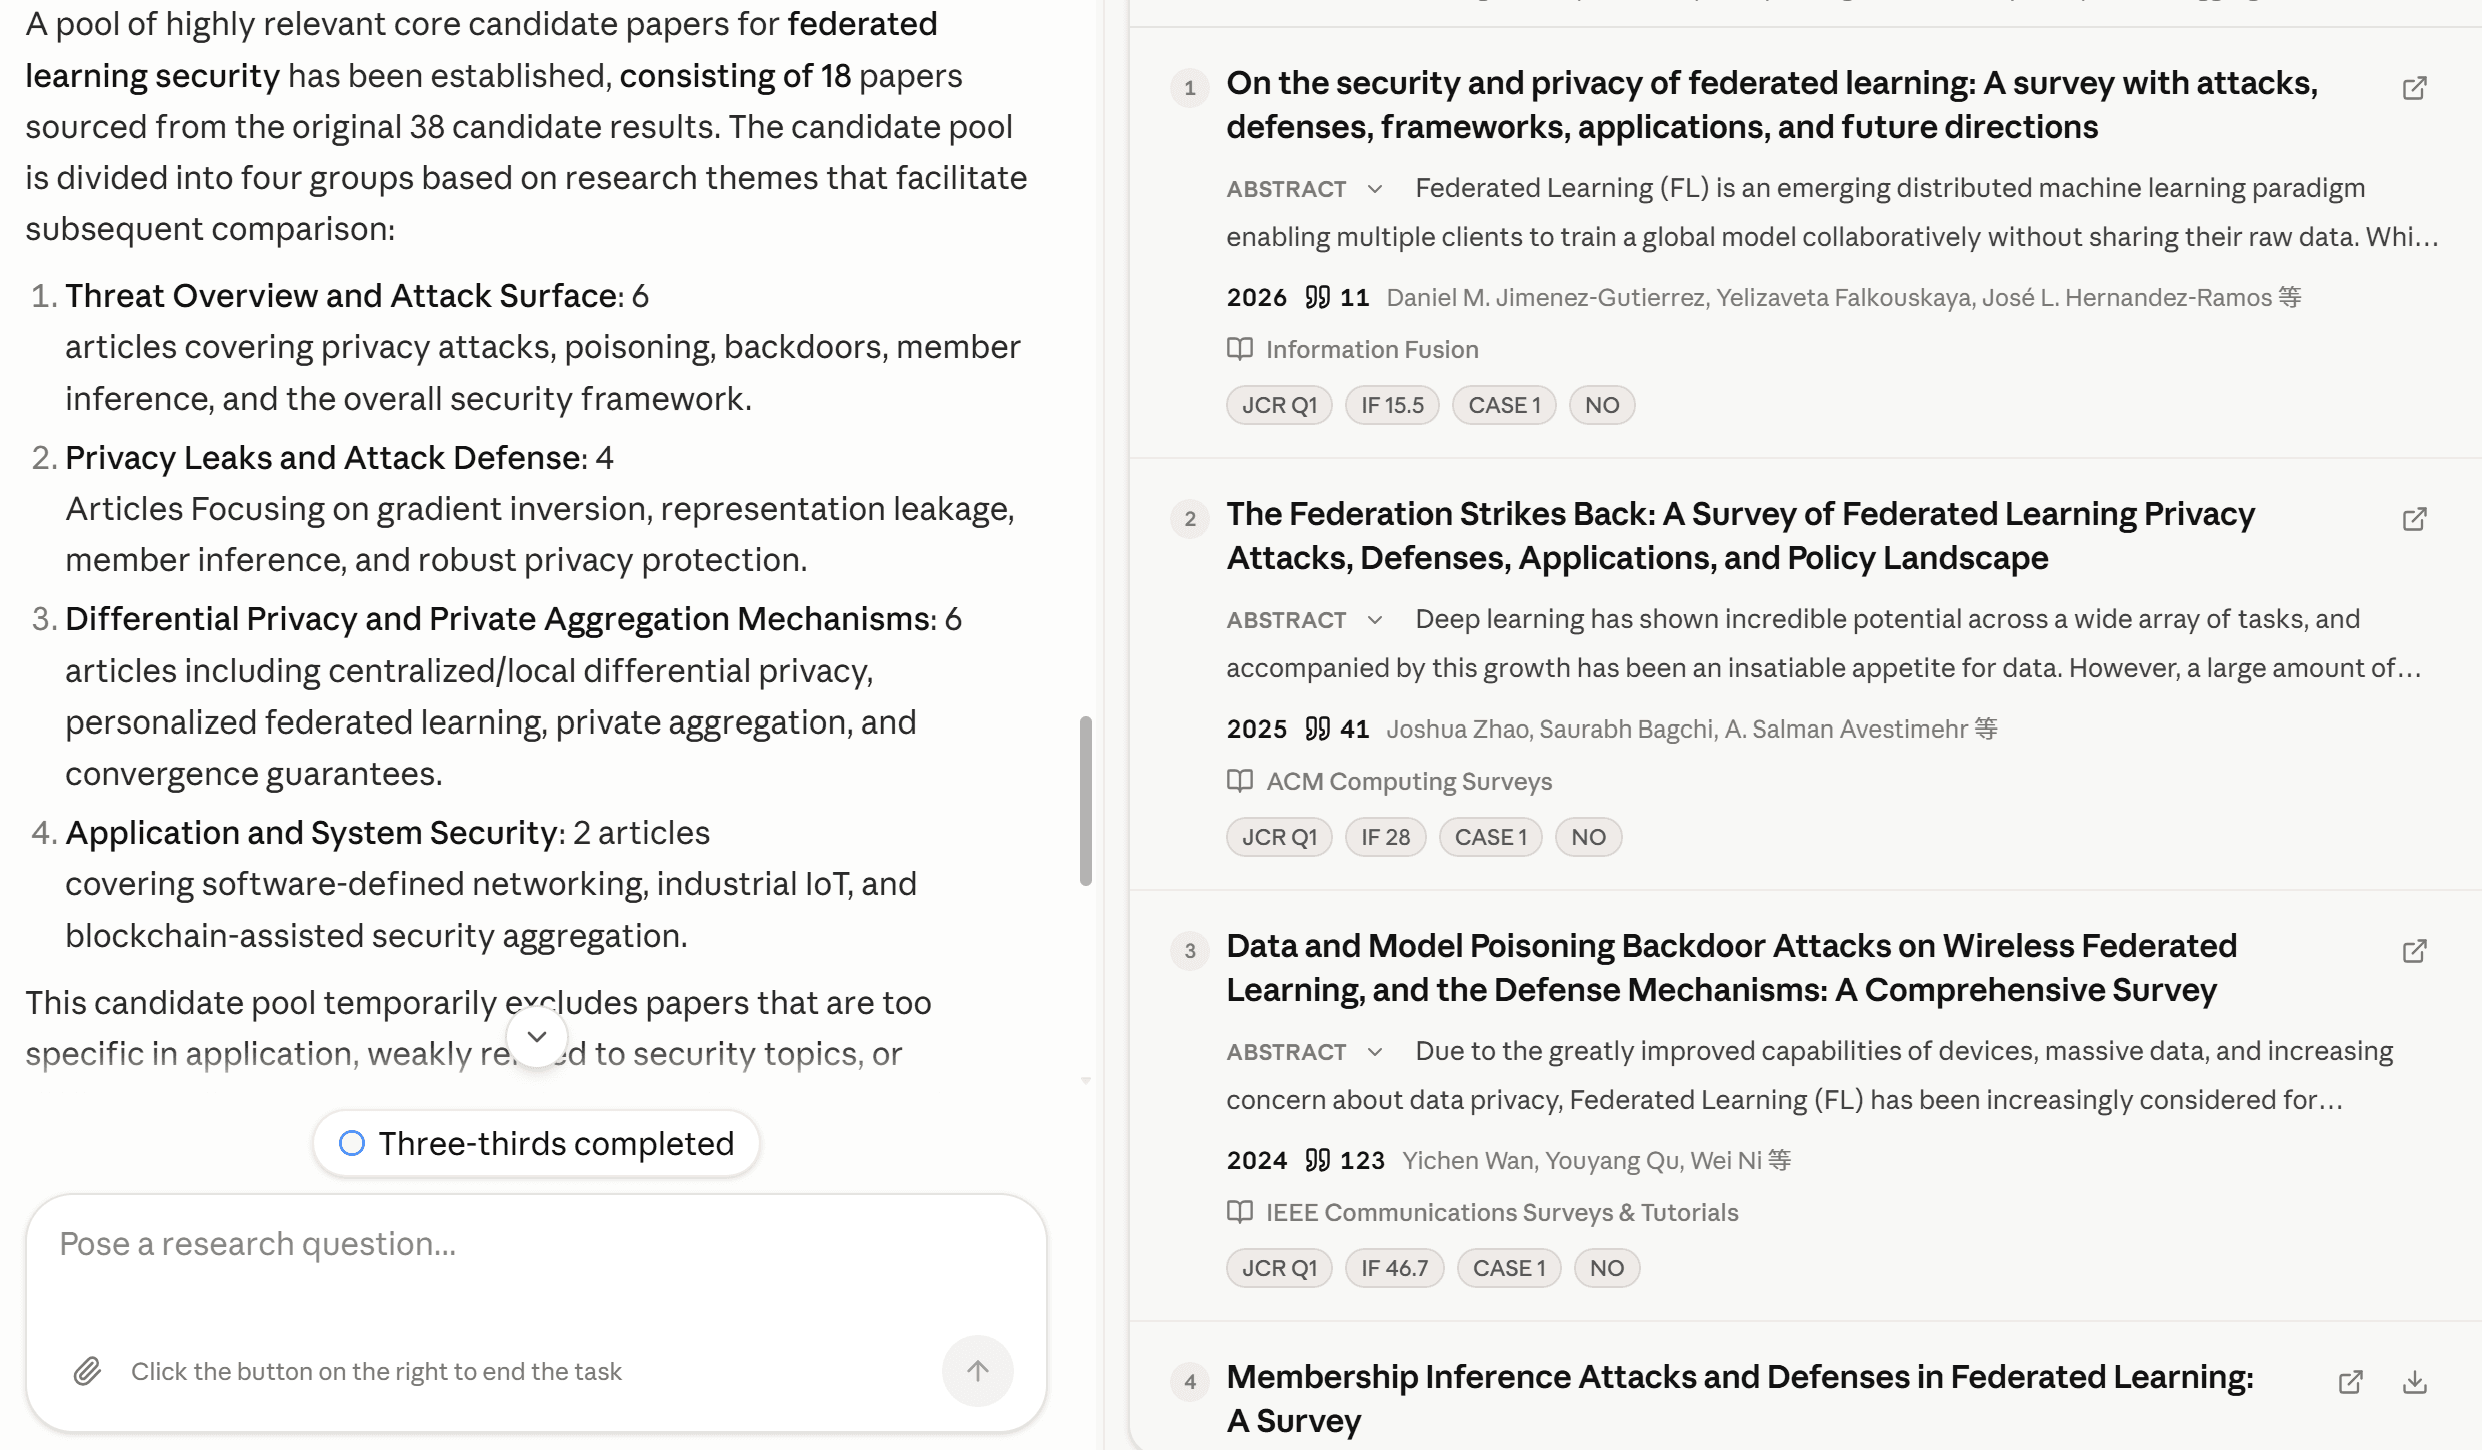
Recherche d’articles menée par l’Agent
avec un corpus d’articles candidats enregistré.
Recherche d’articles menée par l’Agent, avec un corpus d’articles candidats enregistré.
The rapid evolution of large language models (LLMs) has driven a transformative shift in artificial intelligence (AI), reshaping both research paradigms and practical applications. Distinguished from their predecessors by unprecedented scale and advanced capabilities, LLMs necessitate new frameworks for understanding their development, behavior, and societal impact. This survey systematically reviews recent advancements in LLM techniques across four key dimensions: (1)…
General reasoning represents a long-standing and formidable challenge in artificial intelligence (AI). Recent breakthroughs, exemplified by large language models (LLMs)1,2 and chain-of-thought (CoT) prompting3, have achieved considerable success on foundational reasoning tasks. However, this success is heavily contingent on extensive human-annotated demonstrations and the capabilities of models are still insufficient for more complex problems. Here we show that the reasoning…
This review critically distinguishes between AI Agents and Agentic AI, offering a structured, conceptual taxonomy, application mapping, and analysis of opportunities and challenges to clarify their divergent design philosophies and capabilities. We begin by outlining the search strategy and foundational definitions, characterizing AI Agents as modular systems driven and enabled by LLMs and LIMs for taskspecific automation. Generative AI is positioned as a precursor providing…
As AI for Science continues to grow, Physics-informed neural networks (PINNs) have emerged as a transformative approach within the realm of scientific computing and deep learning, offering a robust and flexible framework for solving partial differential equations (PDEs) and other complex physical systems. By embedding physical laws directly into the architecture of neural networks, PINNs enable the integration of domain-specific knowledge, ensuring that the models adhere to…
avec un corpus d’articles candidats enregistré.
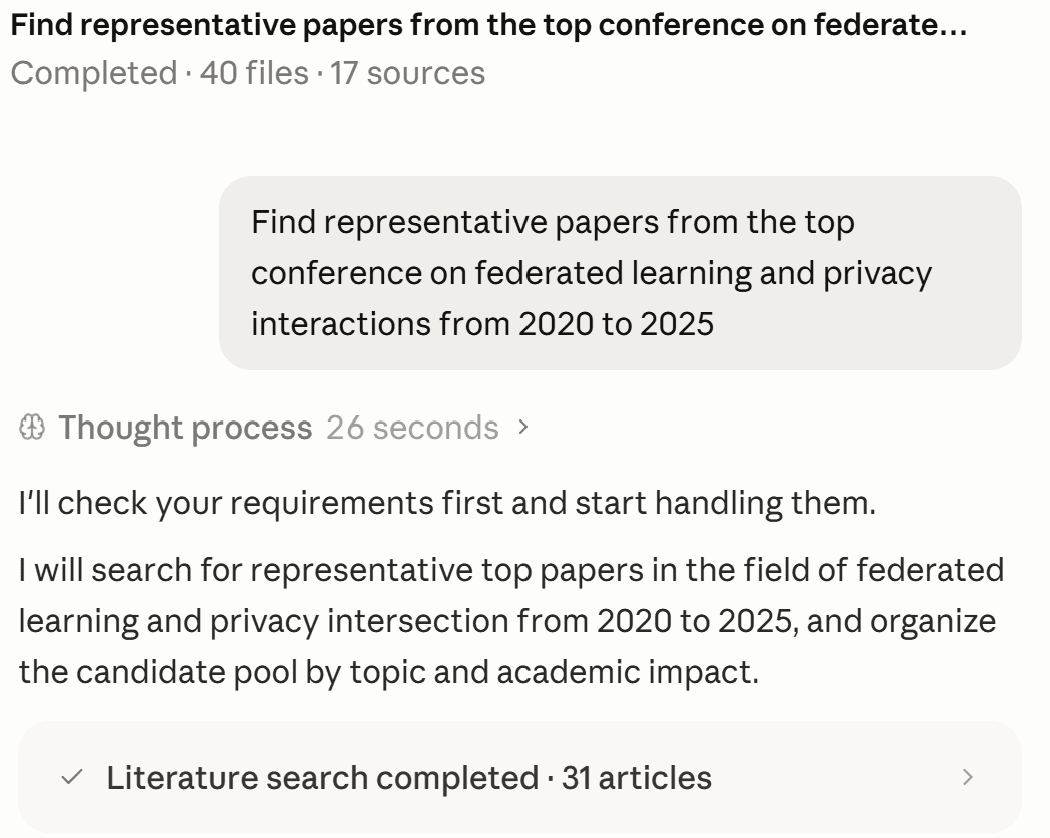
Sources privilégiées, Nombre d’articles candidats, Langue de sortie
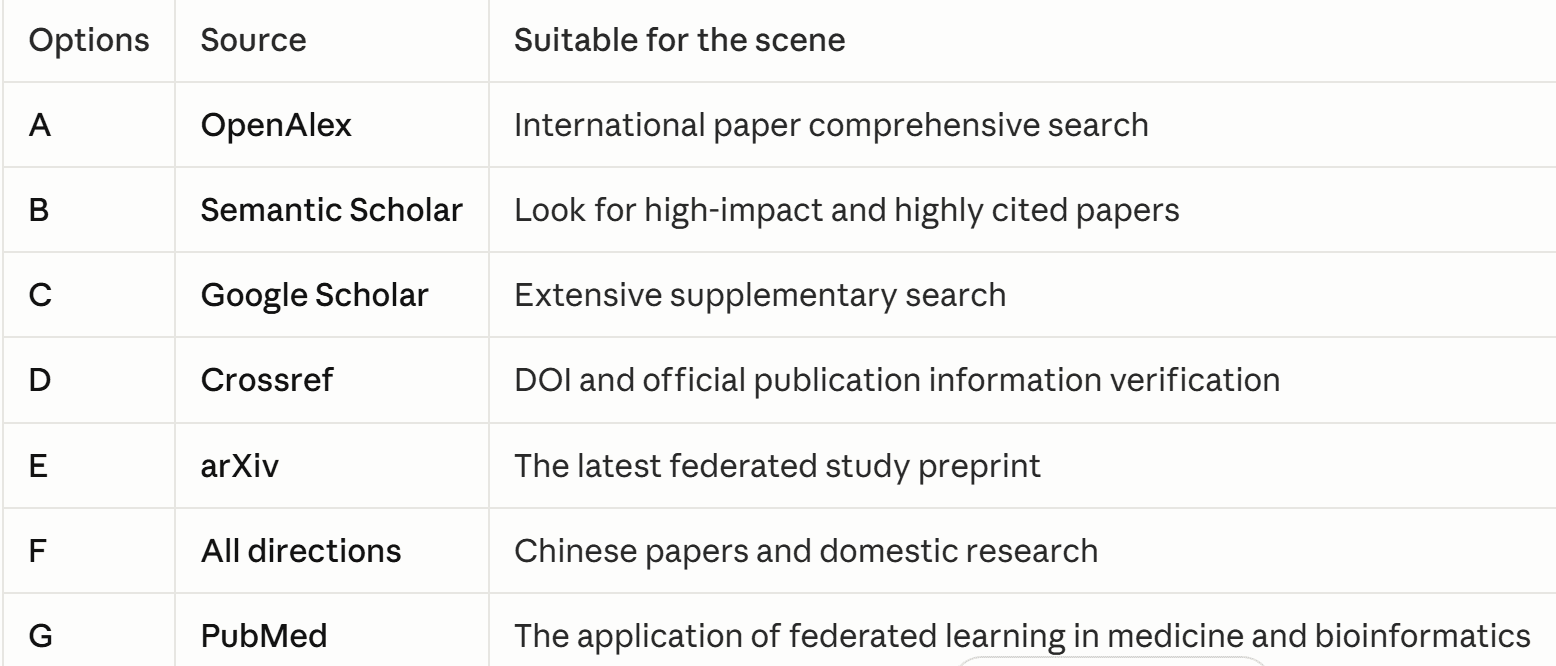
Traiter le sujet et les préférences structurées comme des contraintes fixées par l’utilisateur. Ne demander de précision que pour un choix manquant qui changerait sensiblement le résultat ;
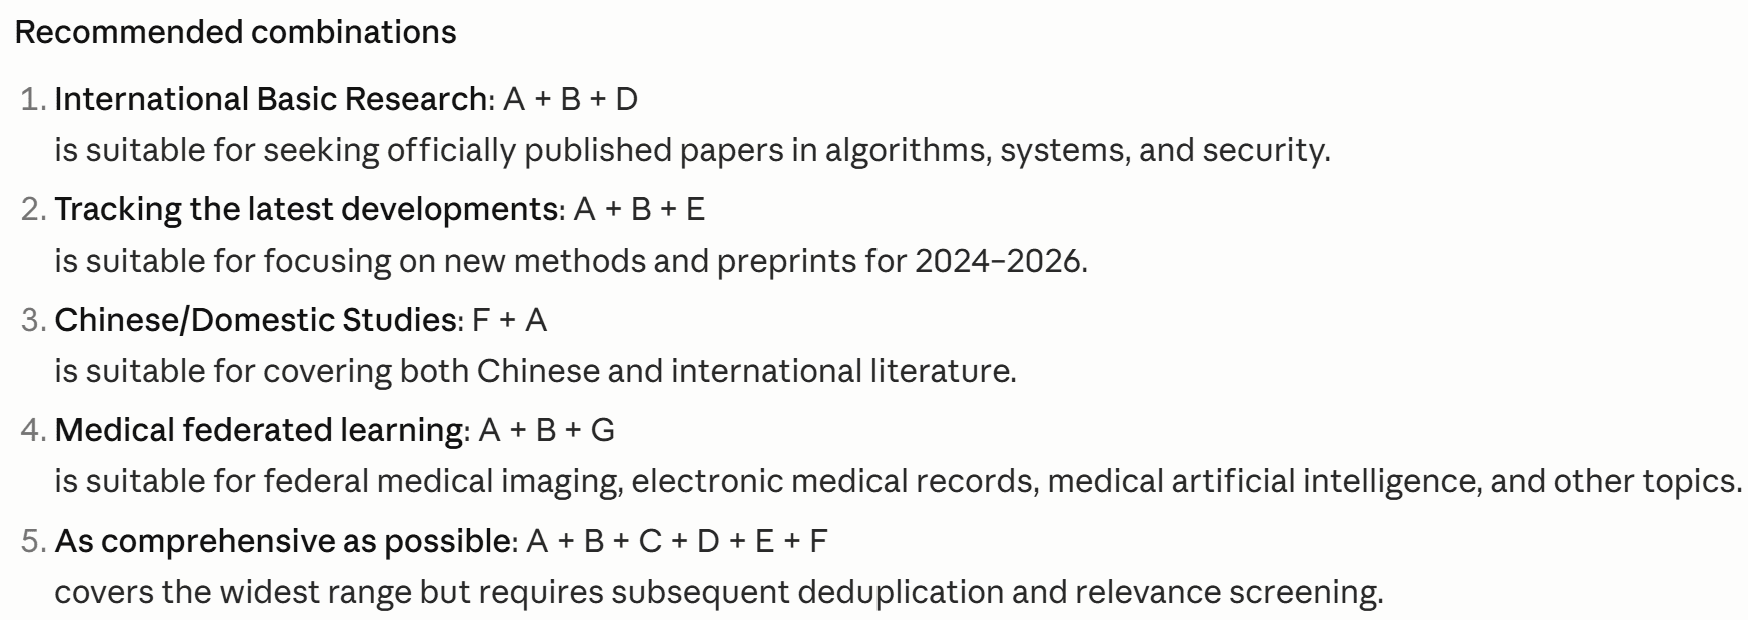
Utiliser search_papers_v2 dans la même conversation du Research Agent. candidate_count est le quota total, plafonné, du corpus. L’outil exécute le plan de sources et de requêtes rédigé par l’Agent et renvoie les recherches réellement effectuées, les échecs,.
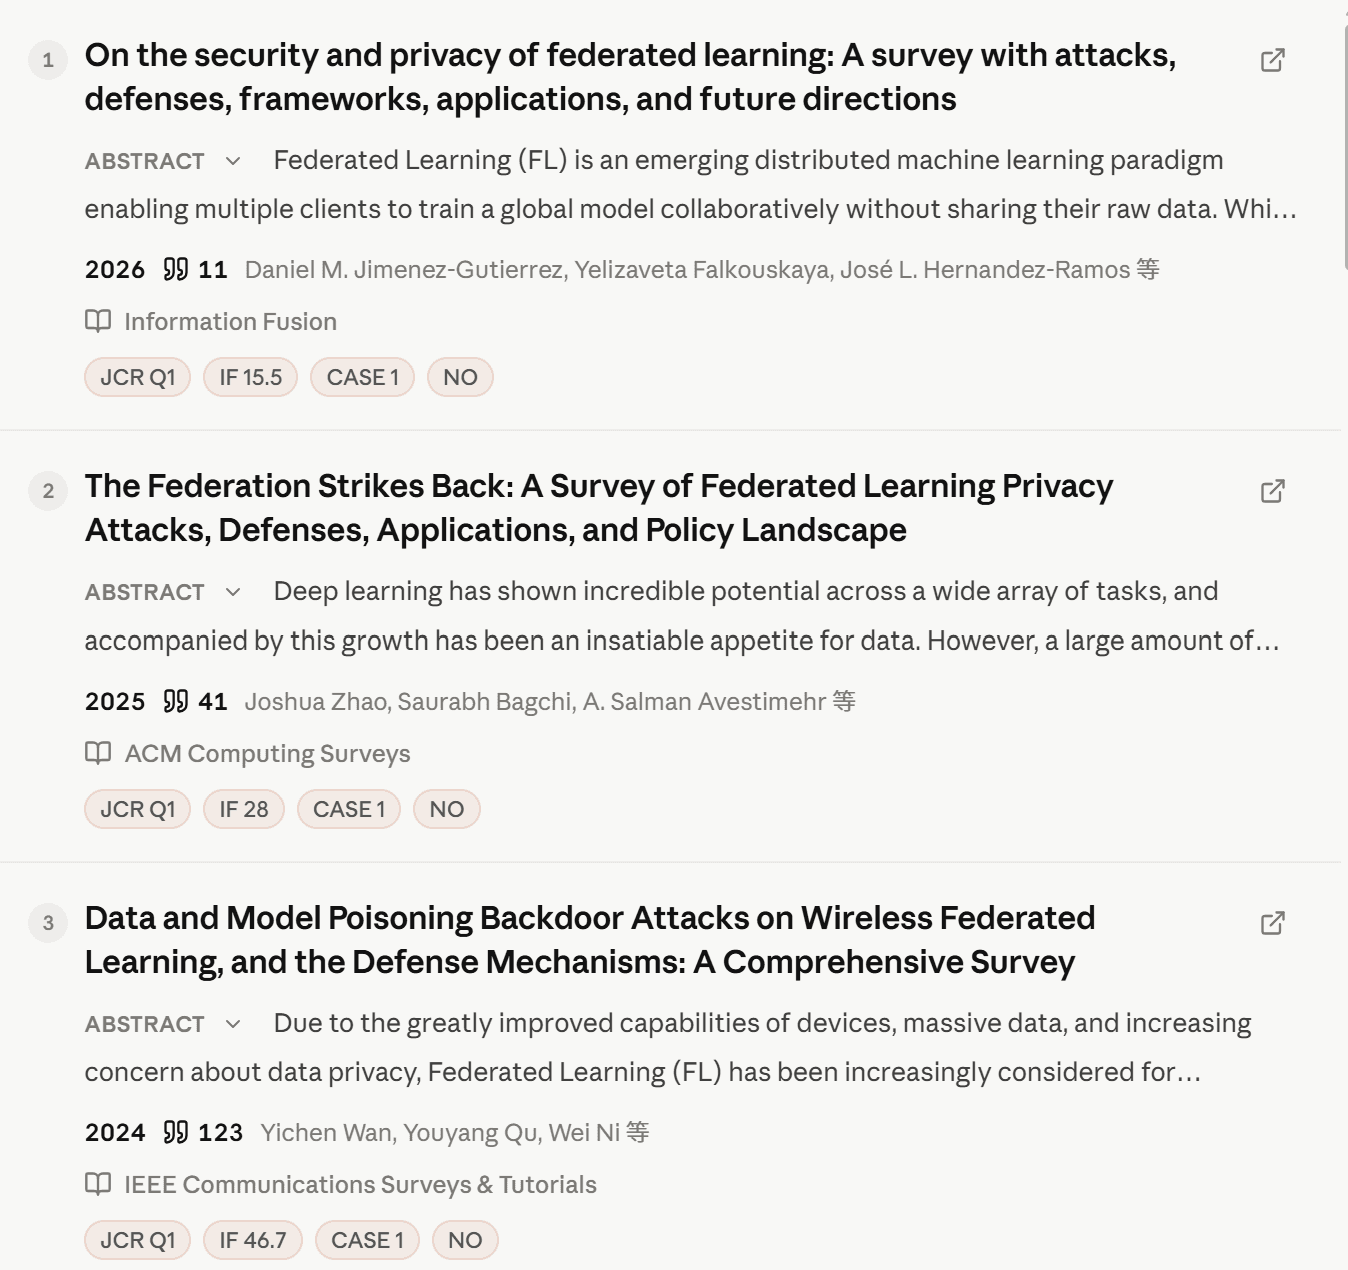
Examiner les métadonnées des articles renvoyés et les diagnostics. La pertinence pour la question de l’utilisateur passe avant le prestige de la revue. Yila garde visibles les décisions intermédiaires, le périmètre des preuves et les questions en suspens, pour.
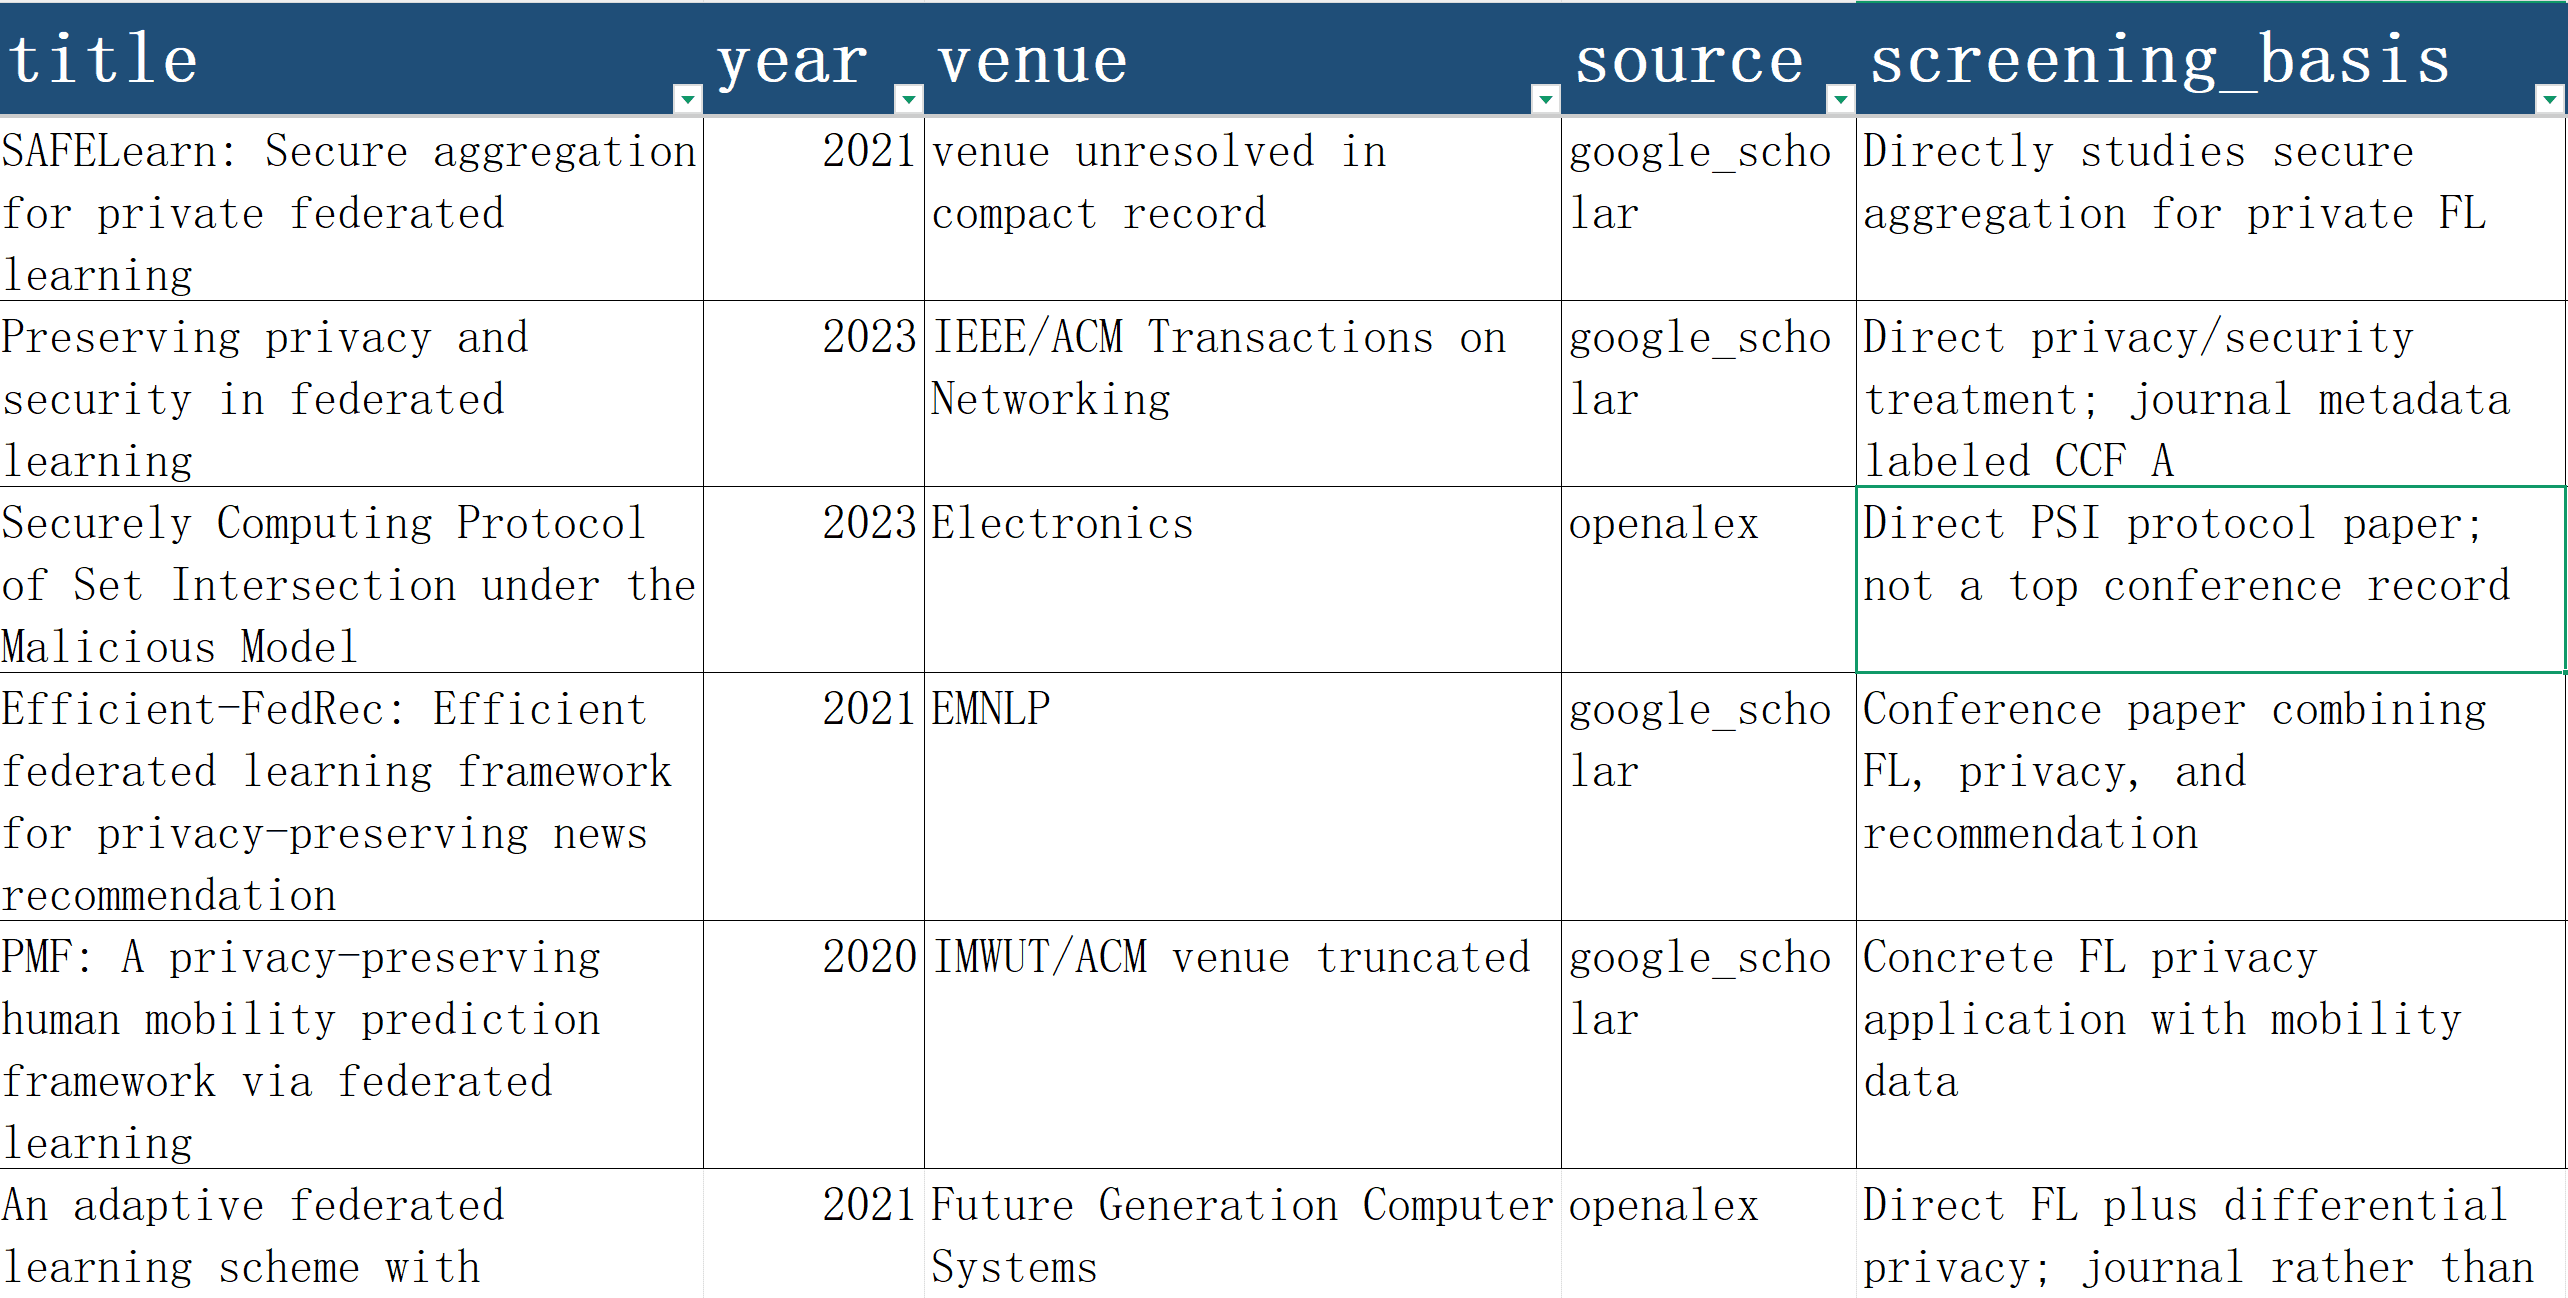
Paper Search v2 enregistre ensemble candidate-paper-pool.json et candidate-paper-pool.xlsx. Ne pas appeler save_paper_pool séparément pour ce corpus initial. Répondre en suivant les consignes générales de recherche d’articles, sans coller le corpus complet.
Passez à l’étape utile suivante sans tout recommencer.
Ouvrez l’espace de travail Yila et indiquez votre question ou fournissez vos documents. Yila part de la méthode choisie, dans la même conversation de recherche.
Lancer ce Playbook