
Préparation de la diffusion des données et du code
Préparer un paquet de données et de code reproductible et une déclaration de disponibilité prête pour la soumission.
Cas d’usage
Vous disposez déjà de : Données et contexte de partage
Objectif de partage
Déroulement
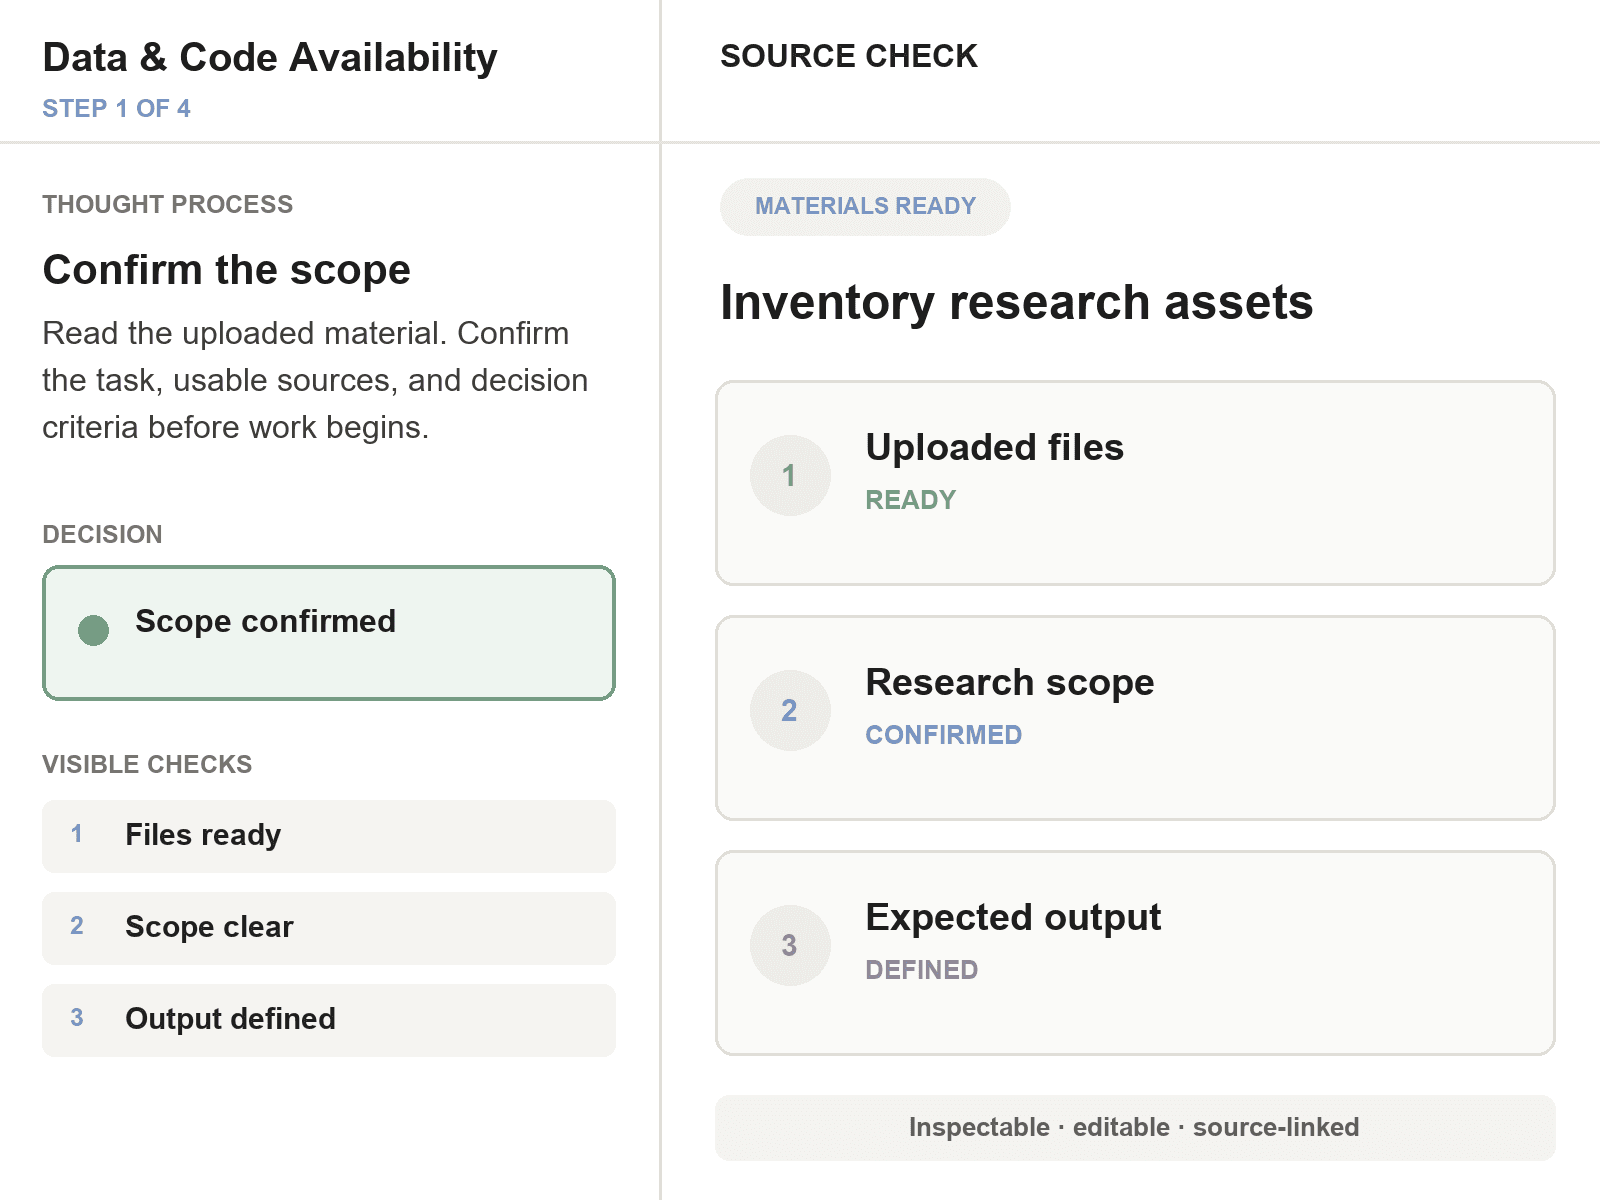
Inventorier les données et le code
Recenser chaque jeu de données, script, notebook, environnement, modèle et contrainte d’accès sur lesquels repose le travail. Cette étape fixe le périmètre, les preuves utilisables et les critères de décision avant le travail de fond, ce qui évite des reprises.
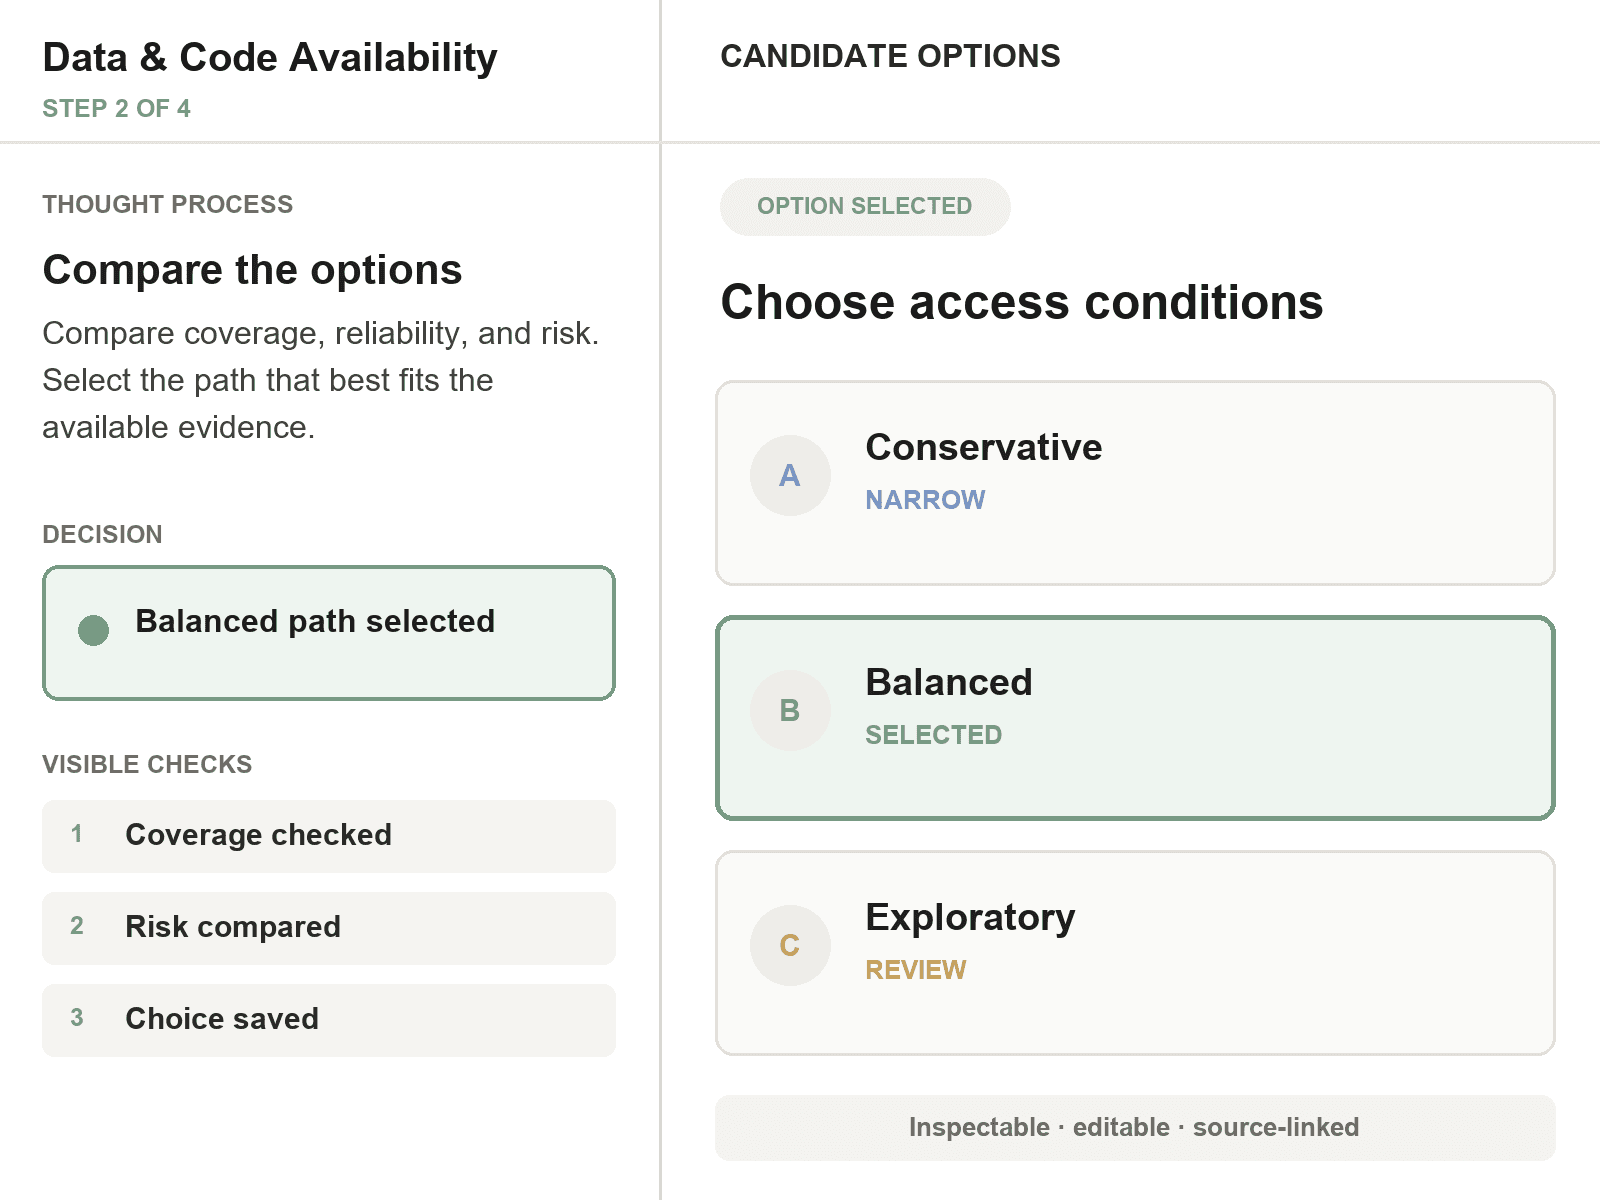
Plan d’entrepôt et d’identifiants
Recommander l’entrepôt, le DOI ou le numéro d’accession, les métadonnées et la manière de citer. Yila garde visibles les décisions intermédiaires, le périmètre des preuves et les questions en suspens, pour que vous puissiez examiner le raisonnement et.
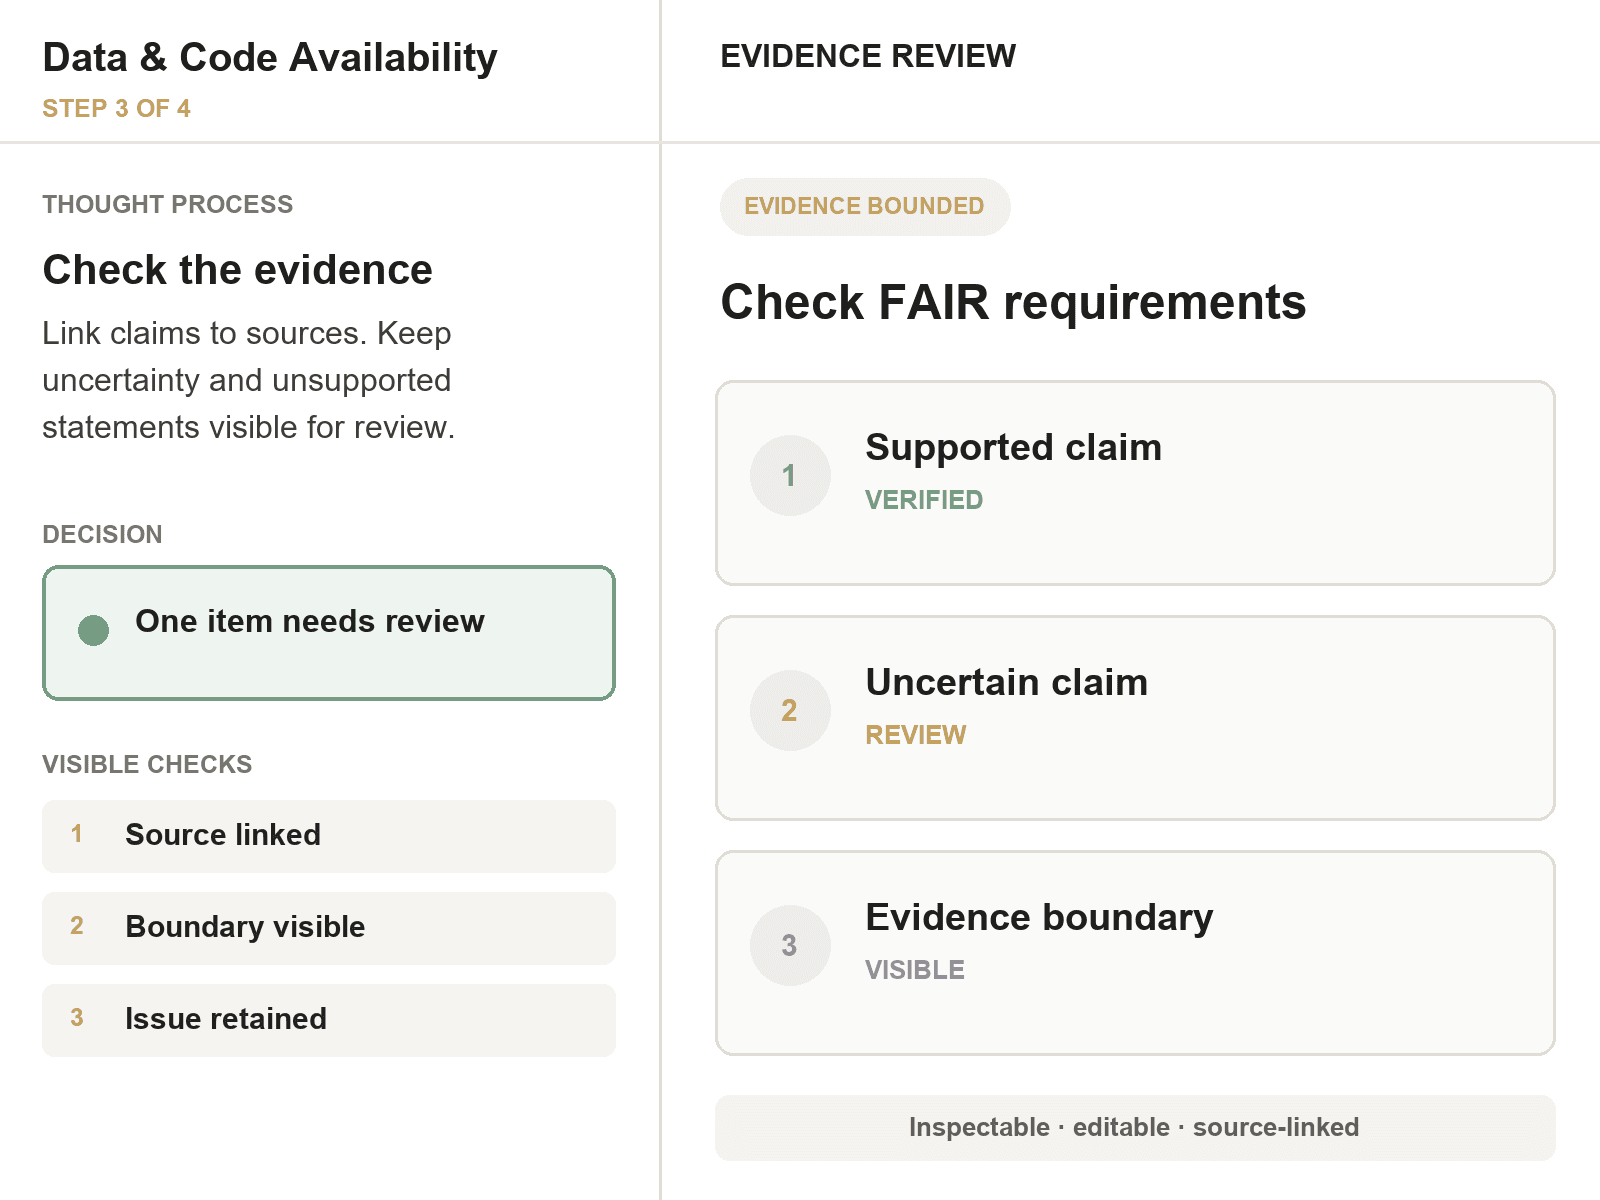
Contrôler la sécurité de la diffusion
Vérifier les métadonnées, les licences, la documentation de l’environnement, la confidentialité et l’exposition de secrets. Yila garde visibles les décisions intermédiaires, le périmètre des preuves et les questions en suspens, pour que vous puissiez examiner.
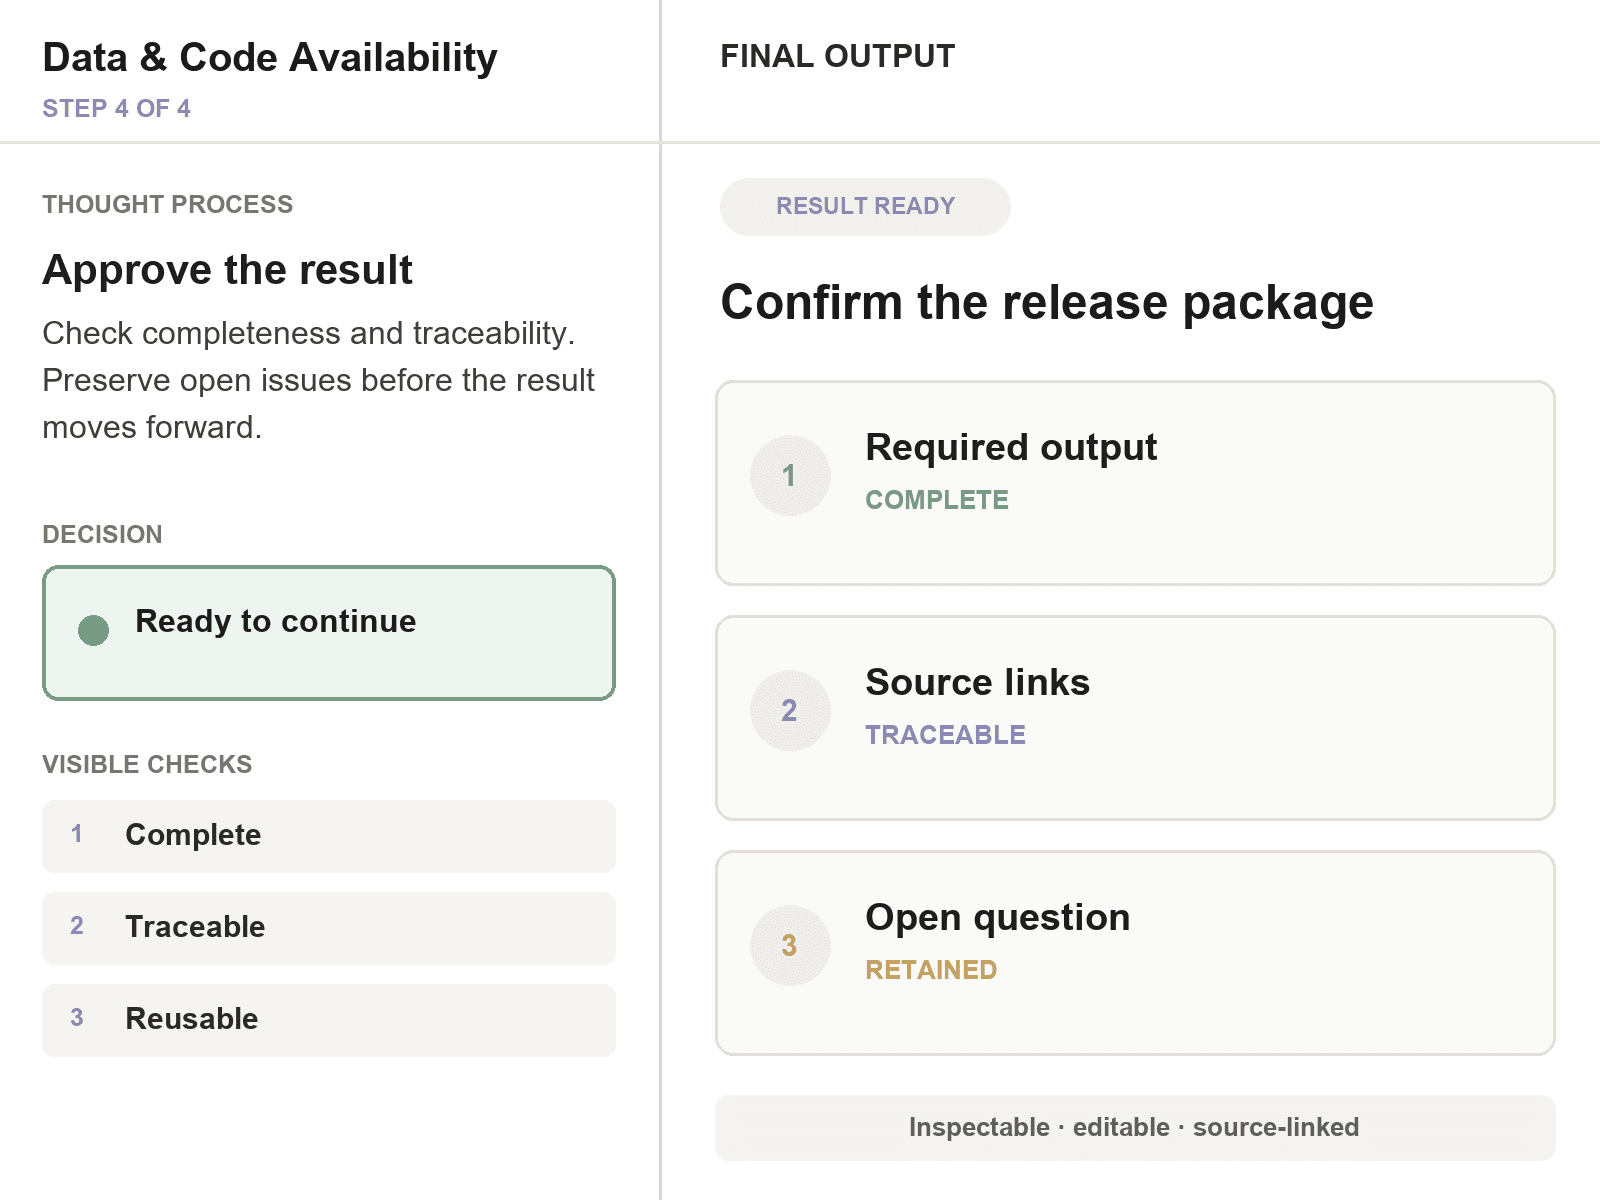
Assembler le paquet de diffusion
Produire une déclaration de disponibilité prête à coller, un README de diffusion et un audit FAIR et de reproductibilité. Avant de passer à la suite, Yila vérifie que le résultat est complet, traçable et prêt à servir l’étape suivante dans la même conversation.
Questions fréquentes
Poursuivez votre recherche
Passez à l’étape utile suivante sans tout recommencer.
Prêt à appliquer ce processus à votre recherche ?
Ouvrez l’espace de travail Yila et indiquez votre question ou fournissez vos documents. Yila part de la méthode choisie, dans la même conversation de recherche.
Lancer ce Playbook