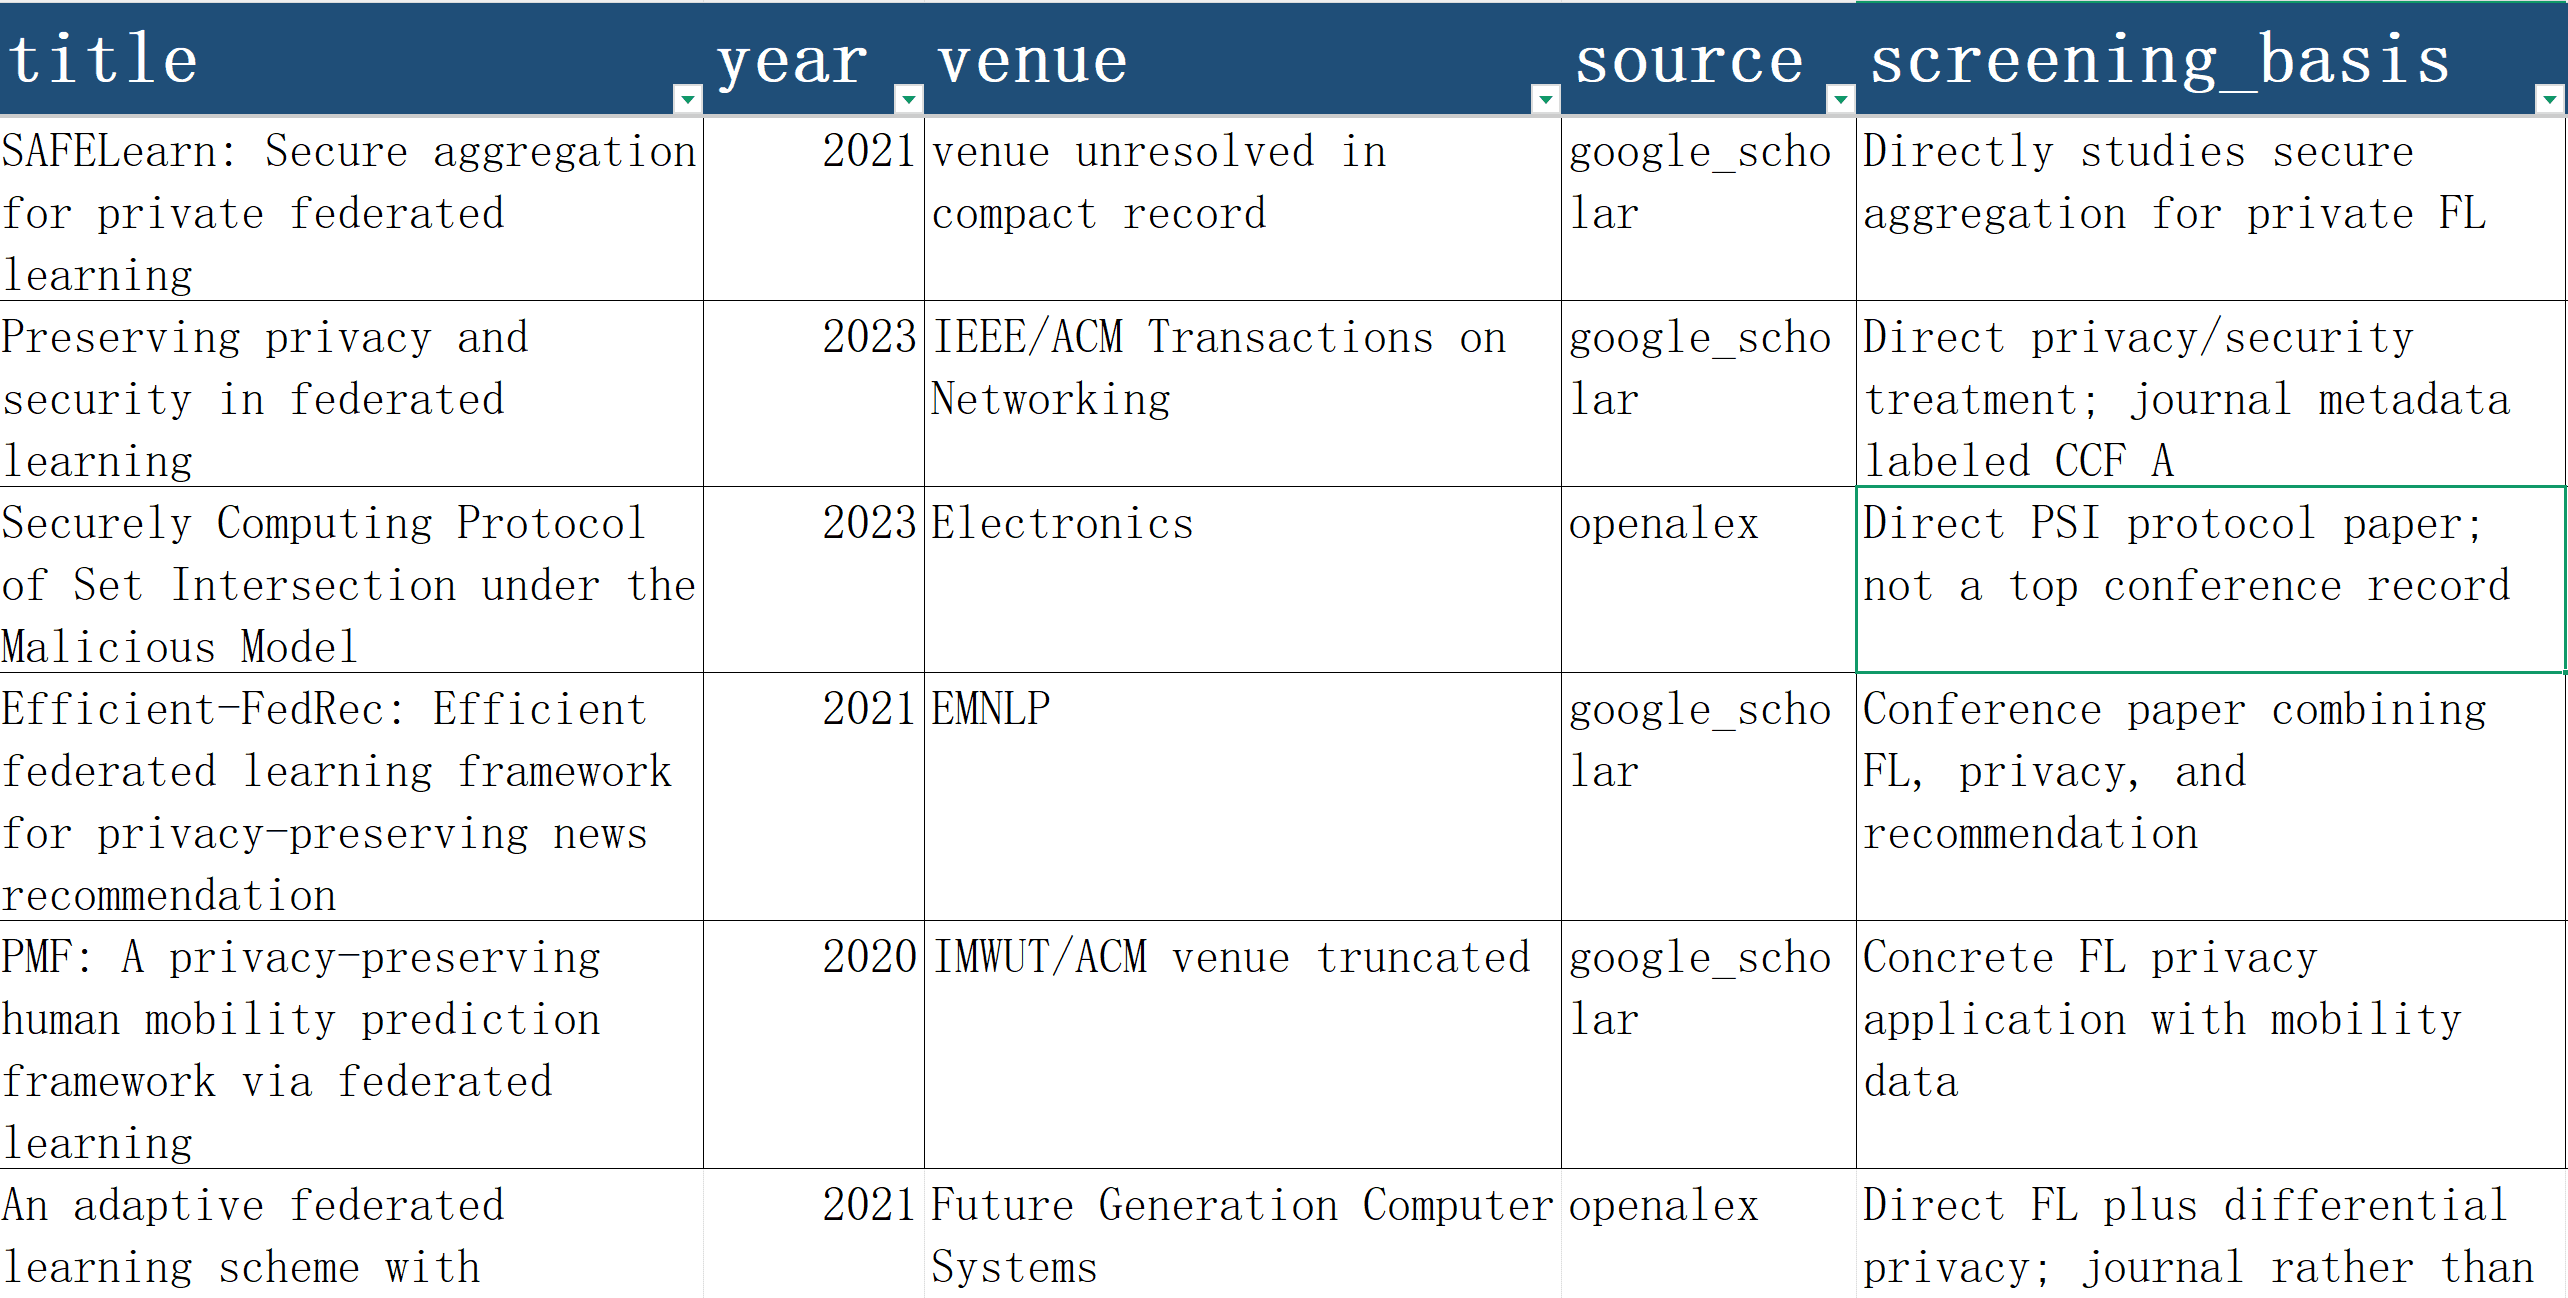
对检索结果去重、筛选和分级
生成有理由、有顺序的阅读清单。
对检索结果去重、筛选和分级,生成有理由、有顺序的阅读清单。
生成有理由、有顺序的阅读清单。
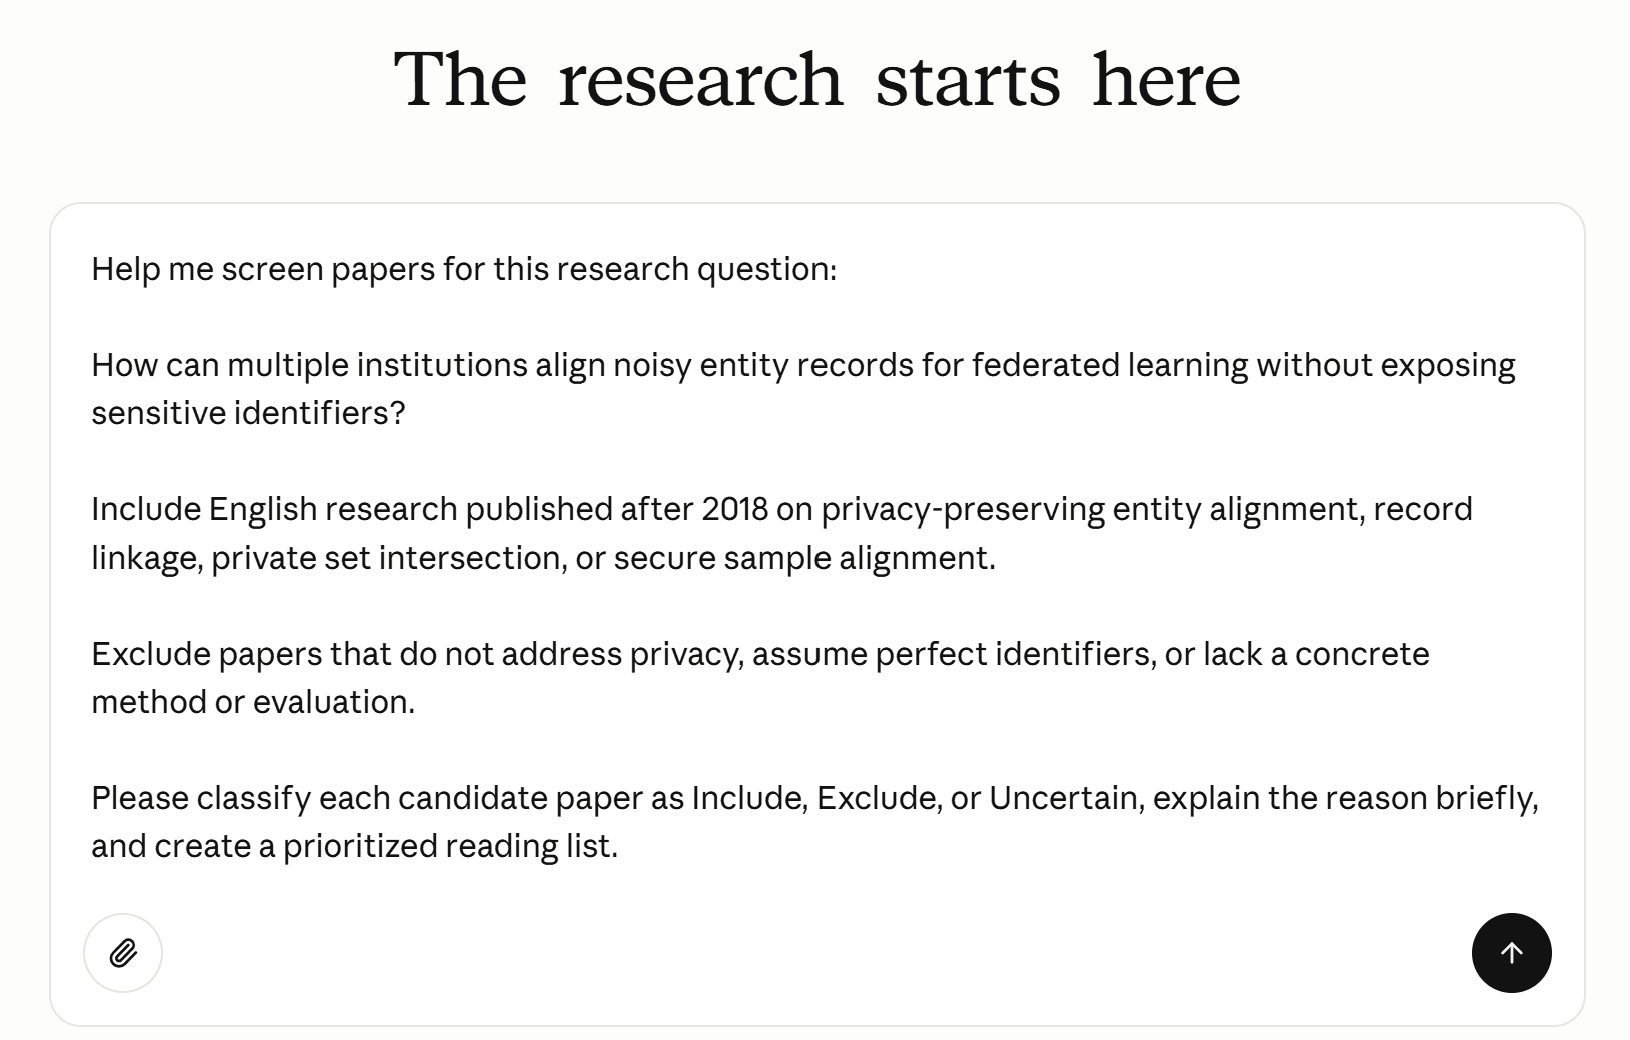
以及已有的纳入与排除标准。
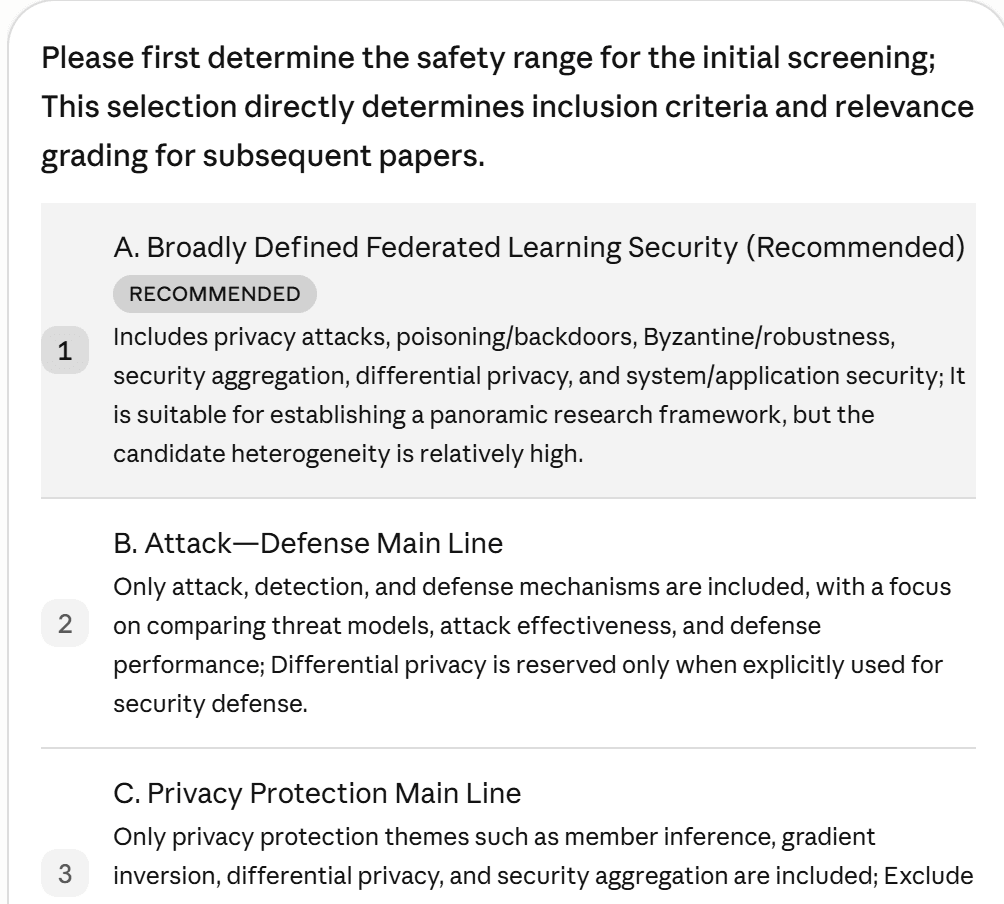
明确研究问题、纳入排除标准和相关性分级。 这一步会先确认任务边界、可用材料和判断标准,避免后续执行偏离你的真实研究目标,也减少不必要的返工。
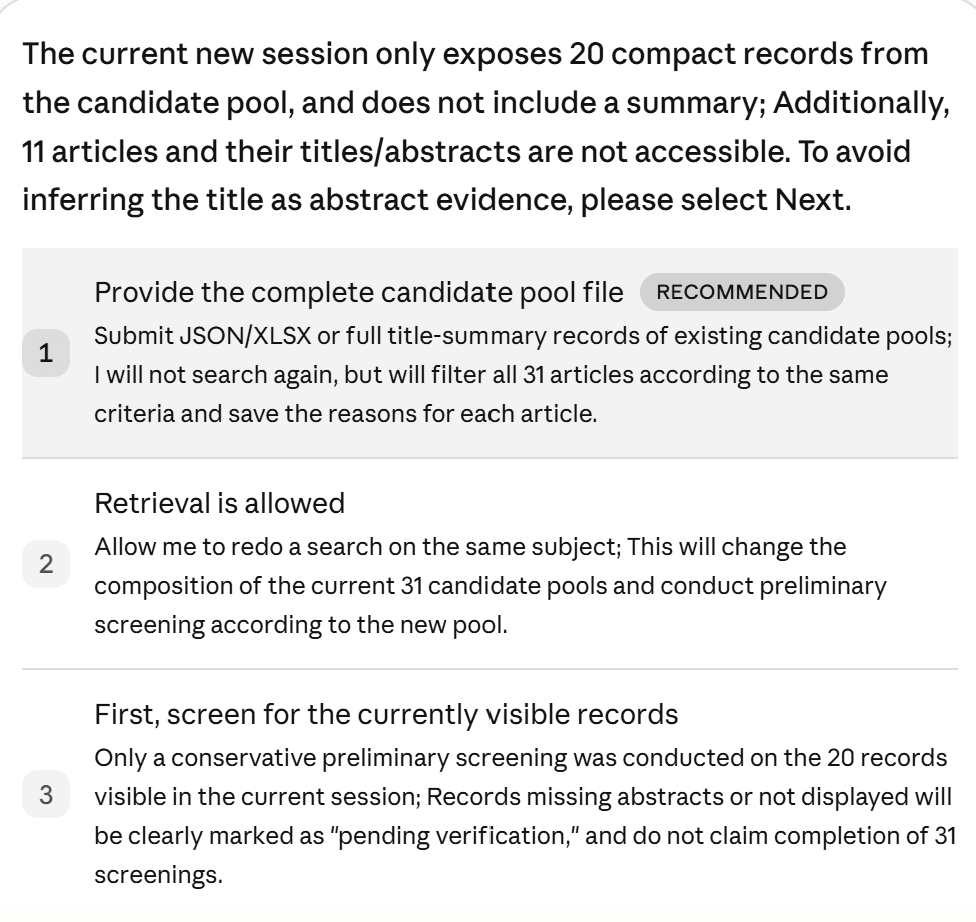
补全元数据并合并重复条目,同时保留来源信息。 Yila 会保留关键的中间判断、证据边界和待确认问题,方便你检查依据,并在需要时及时调整方向。
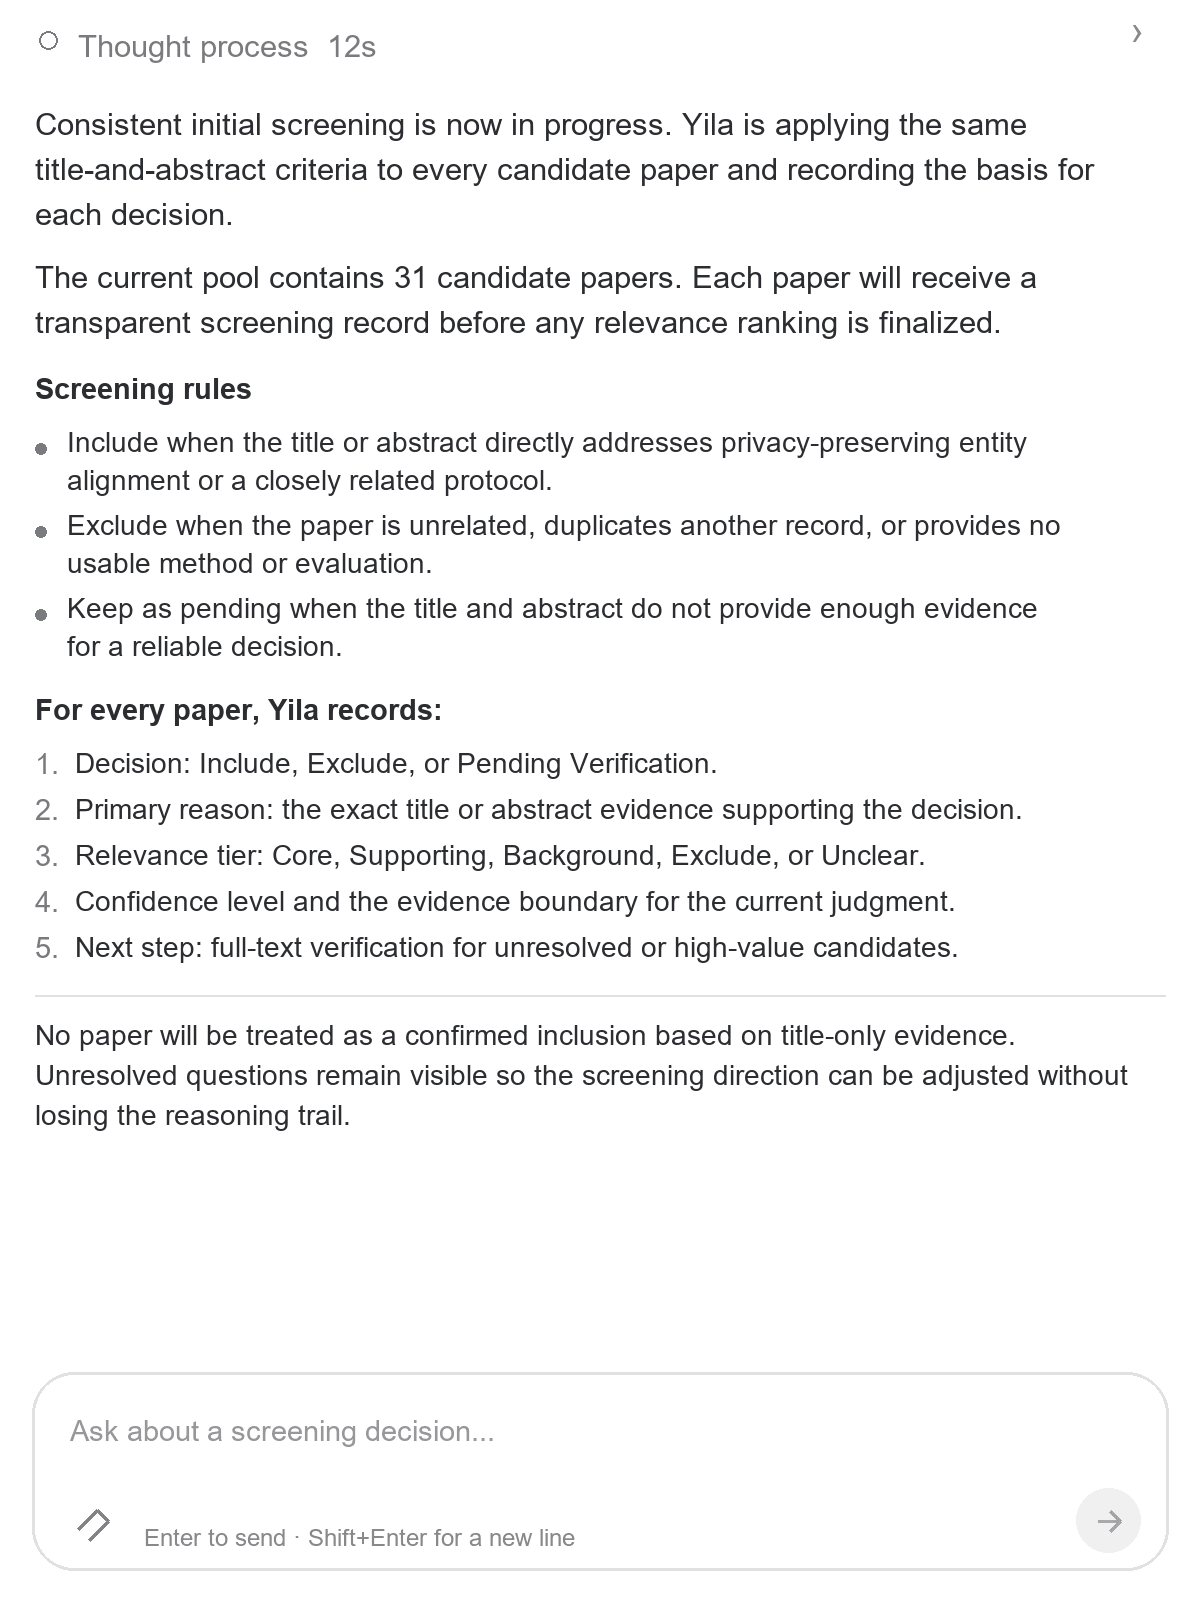
按标题/摘要标准筛选,并为每个决定记录理由。 Yila 会保留关键的中间判断、证据边界和待确认问题,方便你检查依据,并在需要时及时调整方向。
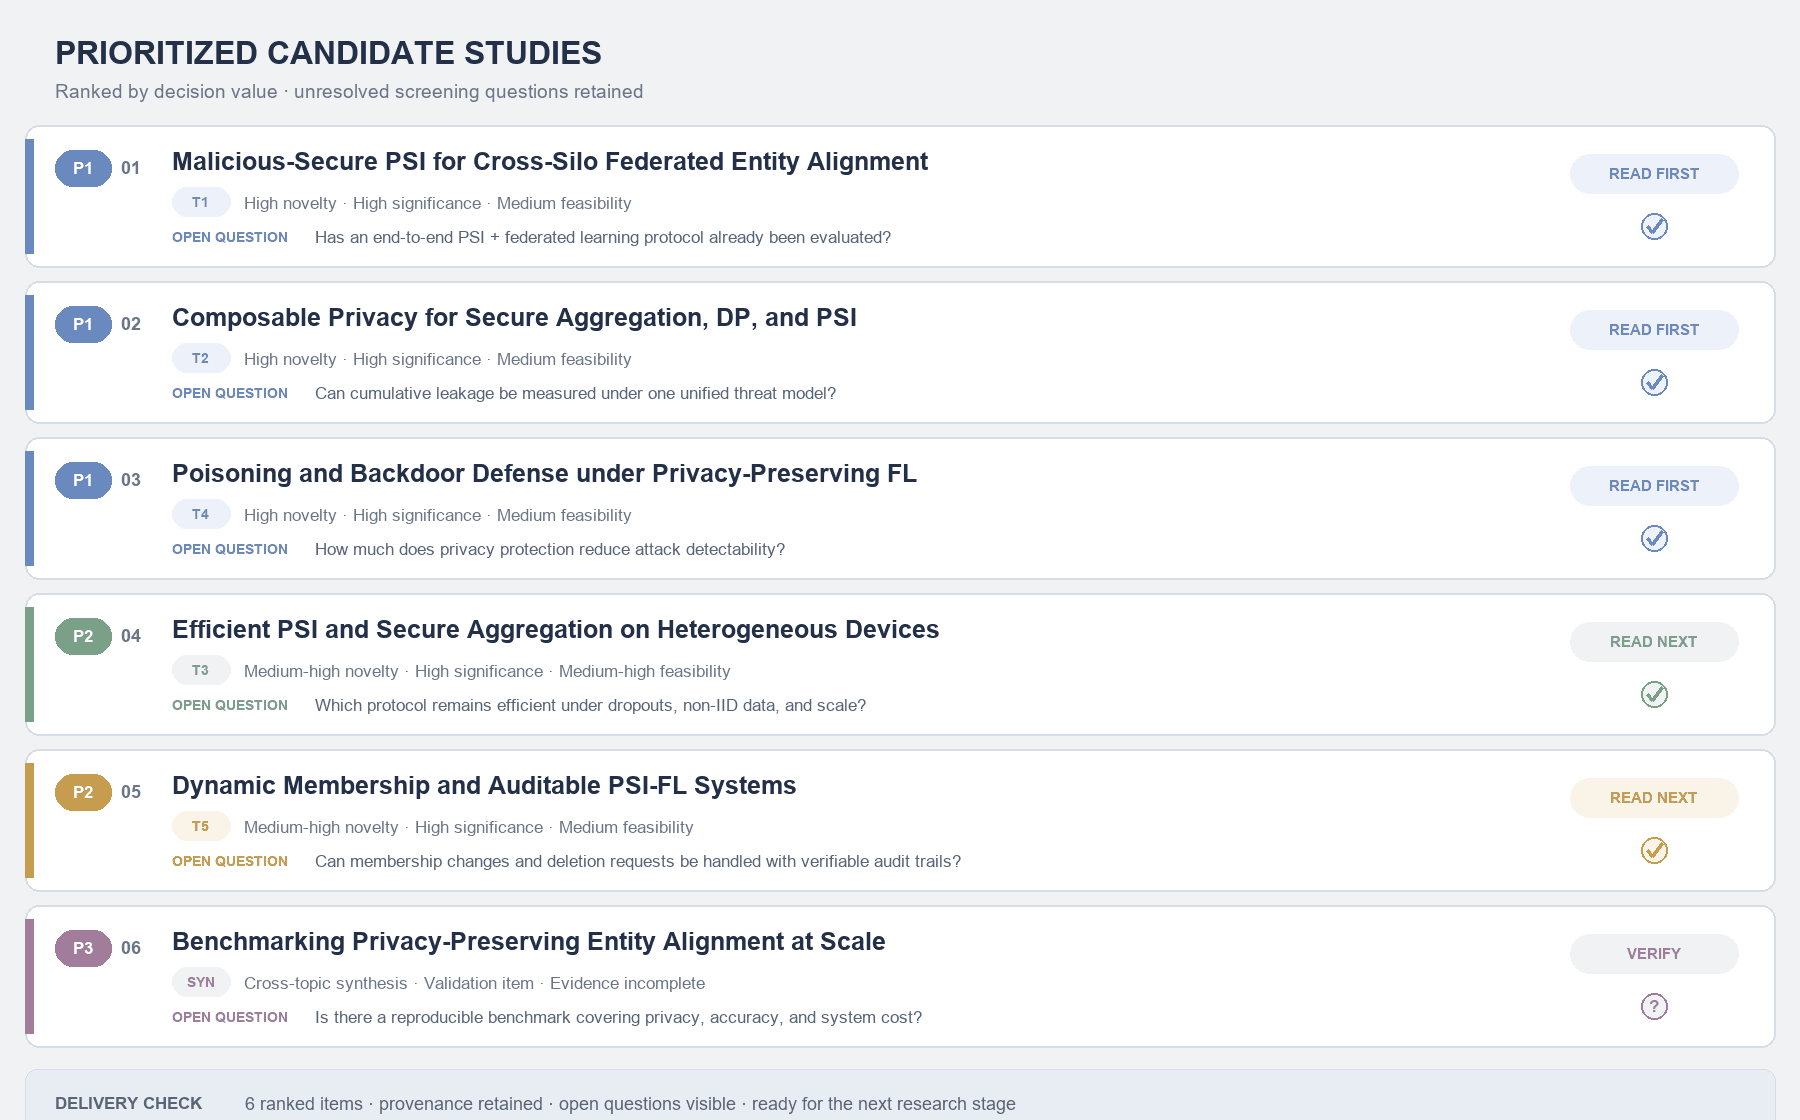
按决策价值为论文排序,并列出未解决的初筛疑问。 进入下一阶段前,Yila 会检查结果是否完整、可追溯且能够继续使用,确保本轮产物可以直接支撑后续研究工作。
沿着科研阶段继续推进,不需要重新整理上下文。