
如何用 Yila 快速完成一次可靠的数据分析
从上传 CSV 或 XLSX 数据、明确研究问题,到检查统计解释、图表和可复用脚本,完整介绍如何用 Yila 完成可靠的数据分析。
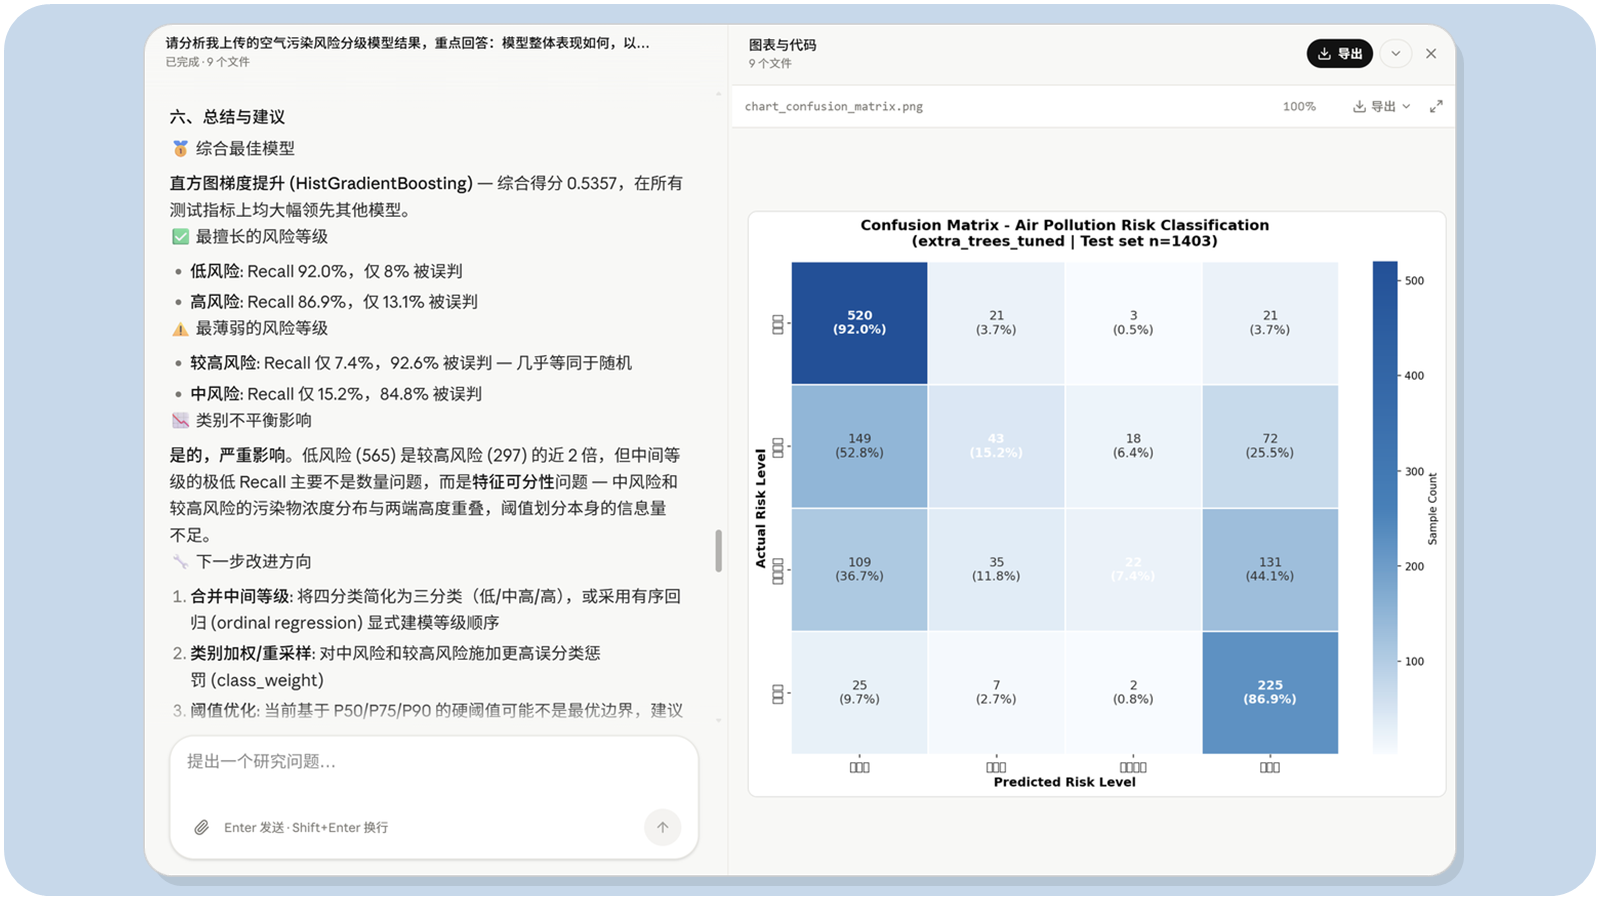
面对一份数据,最难的往往不是“画一张图”,而是先判断数据是否可靠、应该使用什么方法,以及结果到底能说明什么。字段类型、缺失值、样本量和统计假设如果没有检查,图表再漂亮,也可能得出不可靠的结论。
Yila 的数据分析功能可以读取 CSV 或 XLSX 文件。你可以让它先检查数据,也可以直接提出一个研究问题。Yila 会根据任务选择数据预览、统计分析或绘图路径,并交付结果表、专业图表和可复用脚本。即使不会 Python 或 R,也可以用自然语言完成分析。
本指南将用两个步骤说明怎样开始。数据整理、统计方法、缺失值、P 值、特殊图表和结果复核等内容,放在后面的常见问题中。
2 分钟快速开始
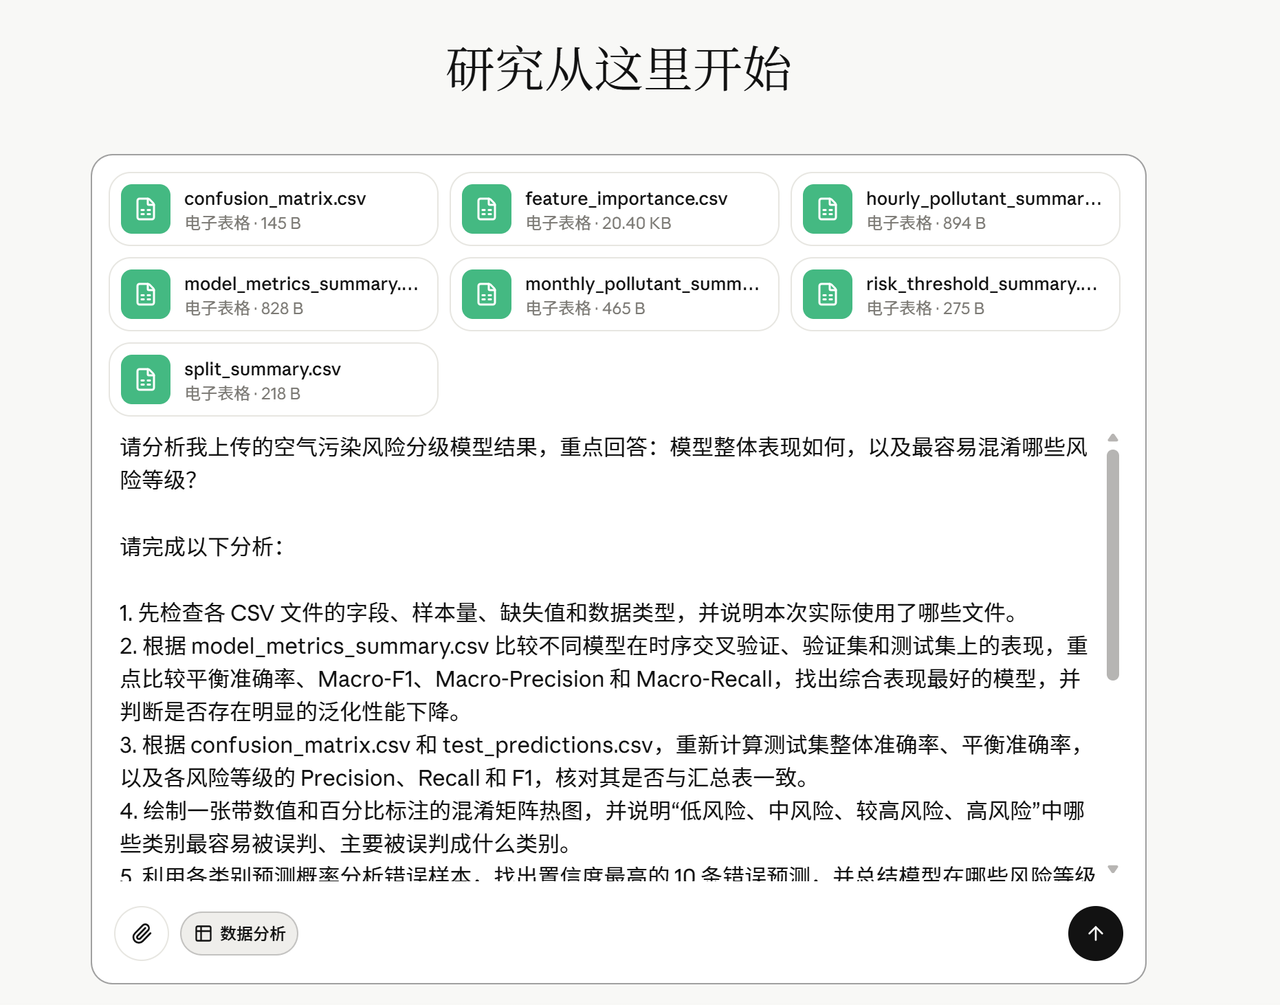
第一步:上传数据并说清楚问题
进入数据分析后,上传 CSV 或 XLSX 文件,然后用一句话说明你想知道什么,例如:
- 这份数据有没有明显的质量问题?
- 两个组之间是否存在差异?
- 两个数值变量是否相关?
- 不同组的生存曲线是否不同?
- 哪些基因达到设定的差异阈值?
如果任务比较复杂,可以同时说明需要检查的字段、比较的指标、统计方法、图表类型和期望交付文件。
第二步:查看解释并下载结果
分析完成后,先阅读文字解释,再查看结果表和图表。重点检查:
- 数据清洗和缺失值是怎样处理的;
- 实际使用了哪些样本和字段;
- 统计方法及其前提是否合理;
- 比较的是哪些变量或组别;
- 结果的不确定性、P 值或其他统计量;
- 图表是否与结果表和文字解释一致。
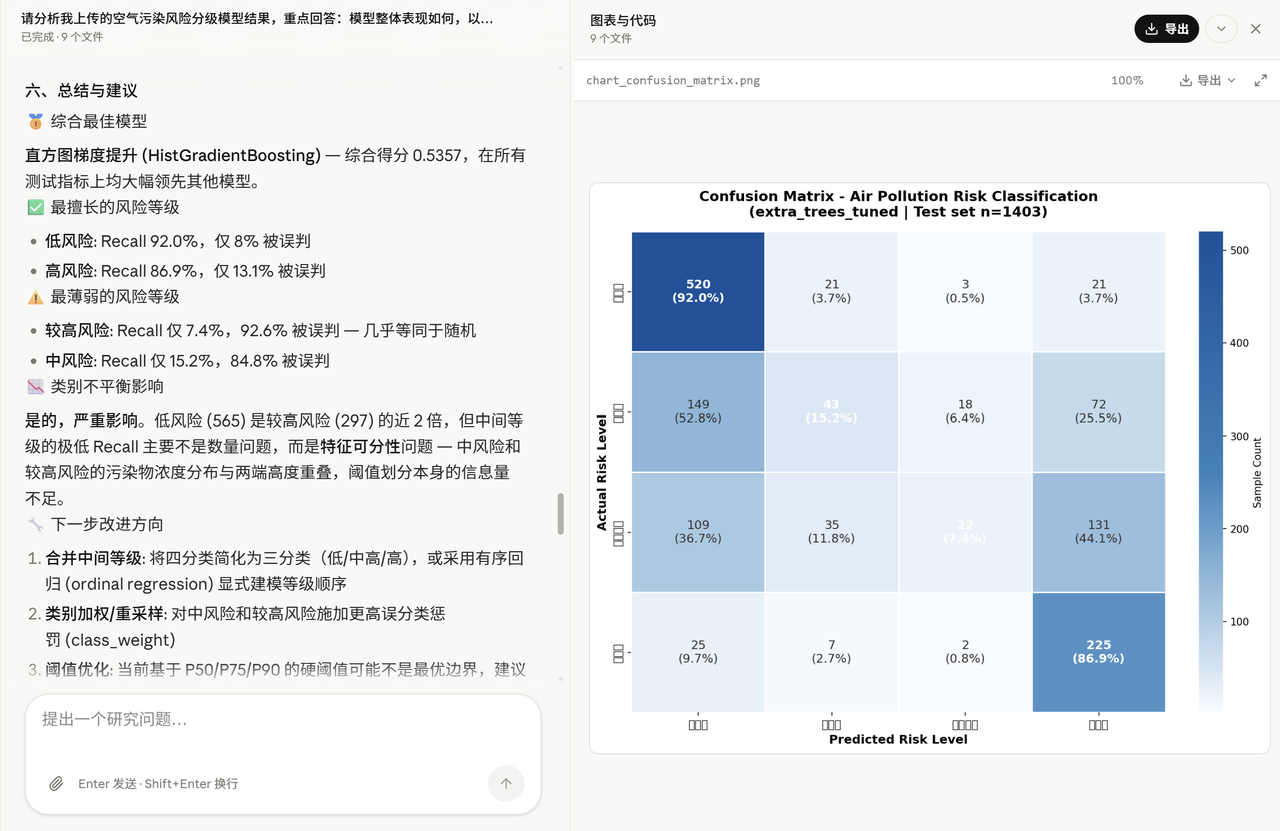
一次完整的数据分析通常会提供:
- analysis-data.csv: 本次分析实际使用的数据;
- statistics-results.csv: 统计结果或汇总结果表;
- chart.png: 高分辨率图表;
- chart.svg: 可编辑矢量图(适用时);
- analysis.py 或 analysis.R: 可复用分析脚本;
- README 或分析说明: 方法、字段和结果解释。
怎样写要求,分析结果会更准确?
1. 先检查数据
请先检查每个字段的数据类型、样本量、缺失值、重复记录、异常值和取值范围,说明可能影响分析质量的问题,再建议适合的后续分析。
2. 比较多个组
比较 A、B、C 三组的主要结局。先检查分布和方差,再选择合适的总体检验与事后比较,报告效应量、置信区间和多重比较校正结果,并绘制带原始数据点的图表。
3. 分析两个变量的相关关系
分析变量 X 与变量 Y 的相关关系。先检查分布、异常值和非线性趋势,再选择 Pearson 或 Spearman 相关;绘制散点图并报告相关系数、置信区间和 P 值。不要把相关性解释为因果关系。
4. 做生存分析
根据随访时间、结局状态和分组变量绘制 Kaplan-Meier 曲线,报告中位生存时间、置信区间和 log-rank 检验;如使用 Cox 模型,请检查比例风险假设并报告风险比。
5. 制作火山图
根据基因名称、log2 fold change 和校正后 P 值制作火山图,明确显著性阈值,标注重点基因,并同时导出达到阈值的结果表。
6. 修改已有图表
在不改变原始数据和统计结果的前提下,调整已有图表的配色、字体、图例、标签、尺寸和导出格式,使其符合目标期刊的单栏或双栏要求。
Yila 数据分析的核心优势
- 先理解问题再选择方法: 不仅执行指定检验,也会结合数据类型和研究问题选择路径。
- 从数据检查开始: 识别字段类型、样本量、缺失值、重复记录和异常范围。
- 结果、图表和脚本一起交付: 便于复核、修改和复现。
- 自然语言即可操作: 不熟悉 Python 或 R 也能提出完整分析要求。
- 支持继续追问和修正: 可以要求更换方法、补充比较、调整图表或解释异常结果。
- 强调结论边界: 区分统计关联、预测表现和因果结论,避免过度解释。
常见问题与补充说明
1. 我不会 Python 或 R,可以使用吗?
可以。用自然语言说明数据是什么、想回答什么问题、需要什么结果即可。生成后仍建议保留脚本,并让熟悉统计分析的人复核关键方法和结论。
2. 支持哪些文件格式?
常用输入包括 CSV 和 XLSX。上传前尽量使用清晰表头、统一编码和规则的表格结构,不要把多个互不相关的表格混在同一工作表中。
3. 数据上传前应该怎样整理?
每行通常代表一个观测对象,每列代表一个变量;使用唯一且清晰的字段名,统一单位和缺失值表示,删除合并单元格和装饰性标题,并准备字段说明和分组编码。
4. 不知道应该做什么分析怎么办?
先让 Yila 检查数据并描述字段、分布、缺失和潜在问题,再说明研究目标。不要在不了解数据结构时直接指定复杂模型。
5. Yila 会自动处理缺失值和异常值吗?
系统可以识别并提出处理方案,但不应在没有说明的情况下随意删除或填补。缺失机制和异常值含义与研究场景有关,最终处理策略需要作者确认。
6. 应该选择“先看数据”还是“统计检验”?
第一次接触数据、字段不清楚或质量不确定时,先看数据。研究问题、变量和方法已经明确时,可以直接提出统计检验要求,但仍应保留基本数据检查。
7. 统计方法是怎样选择的?
主要根据变量类型、组数、独立或配对设计、分布、方差、样本量、重复测量和研究目标选择。方法名称不是唯一重点,其适用前提和结果解释同样重要。
8. P 值应该怎样理解?
P 值表示在统计模型和原假设成立时,观察到当前或更极端数据的概率。它不等于结论为真的概率,也不能代表效应大小。应同时报告效应量和置信区间。
9. 相关分析能证明因果关系吗?
不能。相关关系可能受到混杂、反向因果、选择偏差和测量误差影响。因果结论需要研究设计、时间顺序和更强的识别策略支持。
10. 生存分析需要哪些字段?
至少需要随访时间和结局状态,通常还需要分组变量、个体标识及协变量。必须明确删失编码、时间单位和观察起点。
11. 火山图需要哪些字段?
通常需要特征或基因名称、效应值(如 log2 fold change)和 P 值或校正后 P 值。阈值必须在任务中明确,不能只根据图形外观判断显著性。
12. 可以自己指定图表类型吗?
可以,但图表类型应适合数据和问题。若指定的图表可能误导,应先比较替代方案再决定。
13. chart.svg 为什么有时没有生成?
部分图表或外部组件可能只支持栅格输出,或当前任务使用的渲染路径不适合导出 SVG。需要矢量文件时,应在任务开始前明确说明。
14. analysis-data.csv 和原始数据有什么区别?
analysis-data.csv 是本次分析实际使用的数据,可能经过筛选、字段标准化、类型转换或派生变量计算。它应与原始数据一起保存,并记录处理步骤。
15. 结果可以直接写进论文吗?
不建议未经复核直接使用。应检查数据、方法、样本量、统计假设、结果表、图表和文字解释,并结合研究设计确认结论边界。
16. 数据隐私需要注意什么?
上传前删除不必要的姓名、证件号、联系方式和其他直接标识符。涉及敏感数据时,遵守所在机构的伦理、授权、数据最小化和跨境传输要求。
17. 一次分析大约需要多久?
时间取决于文件大小、数据质量、分析复杂度、图表数量和修订次数。基础检查和简单比较通常较快,复杂建模和多轮复核需要更久。
18. 数据分析和科研绘图有什么区别?
数据分析重点是数据质量、统计方法和结论;科研绘图重点是把已经确认的数据和结论转化为清晰、符合投稿要求的视觉表达。复杂任务通常先完成分析,再制作最终科研图。
总结
使用 Yila 完成可靠数据分析,可以概括为两步:上传数据并说清楚问题,随后检查解释、结果表、图表和脚本并下载交付文件。
最重要的不是尽快得到一个 P 值或一张图,而是确认数据、方法和解释彼此一致。正式使用结果前,应复核原始数据、分析脚本、统计假设和结论边界。