
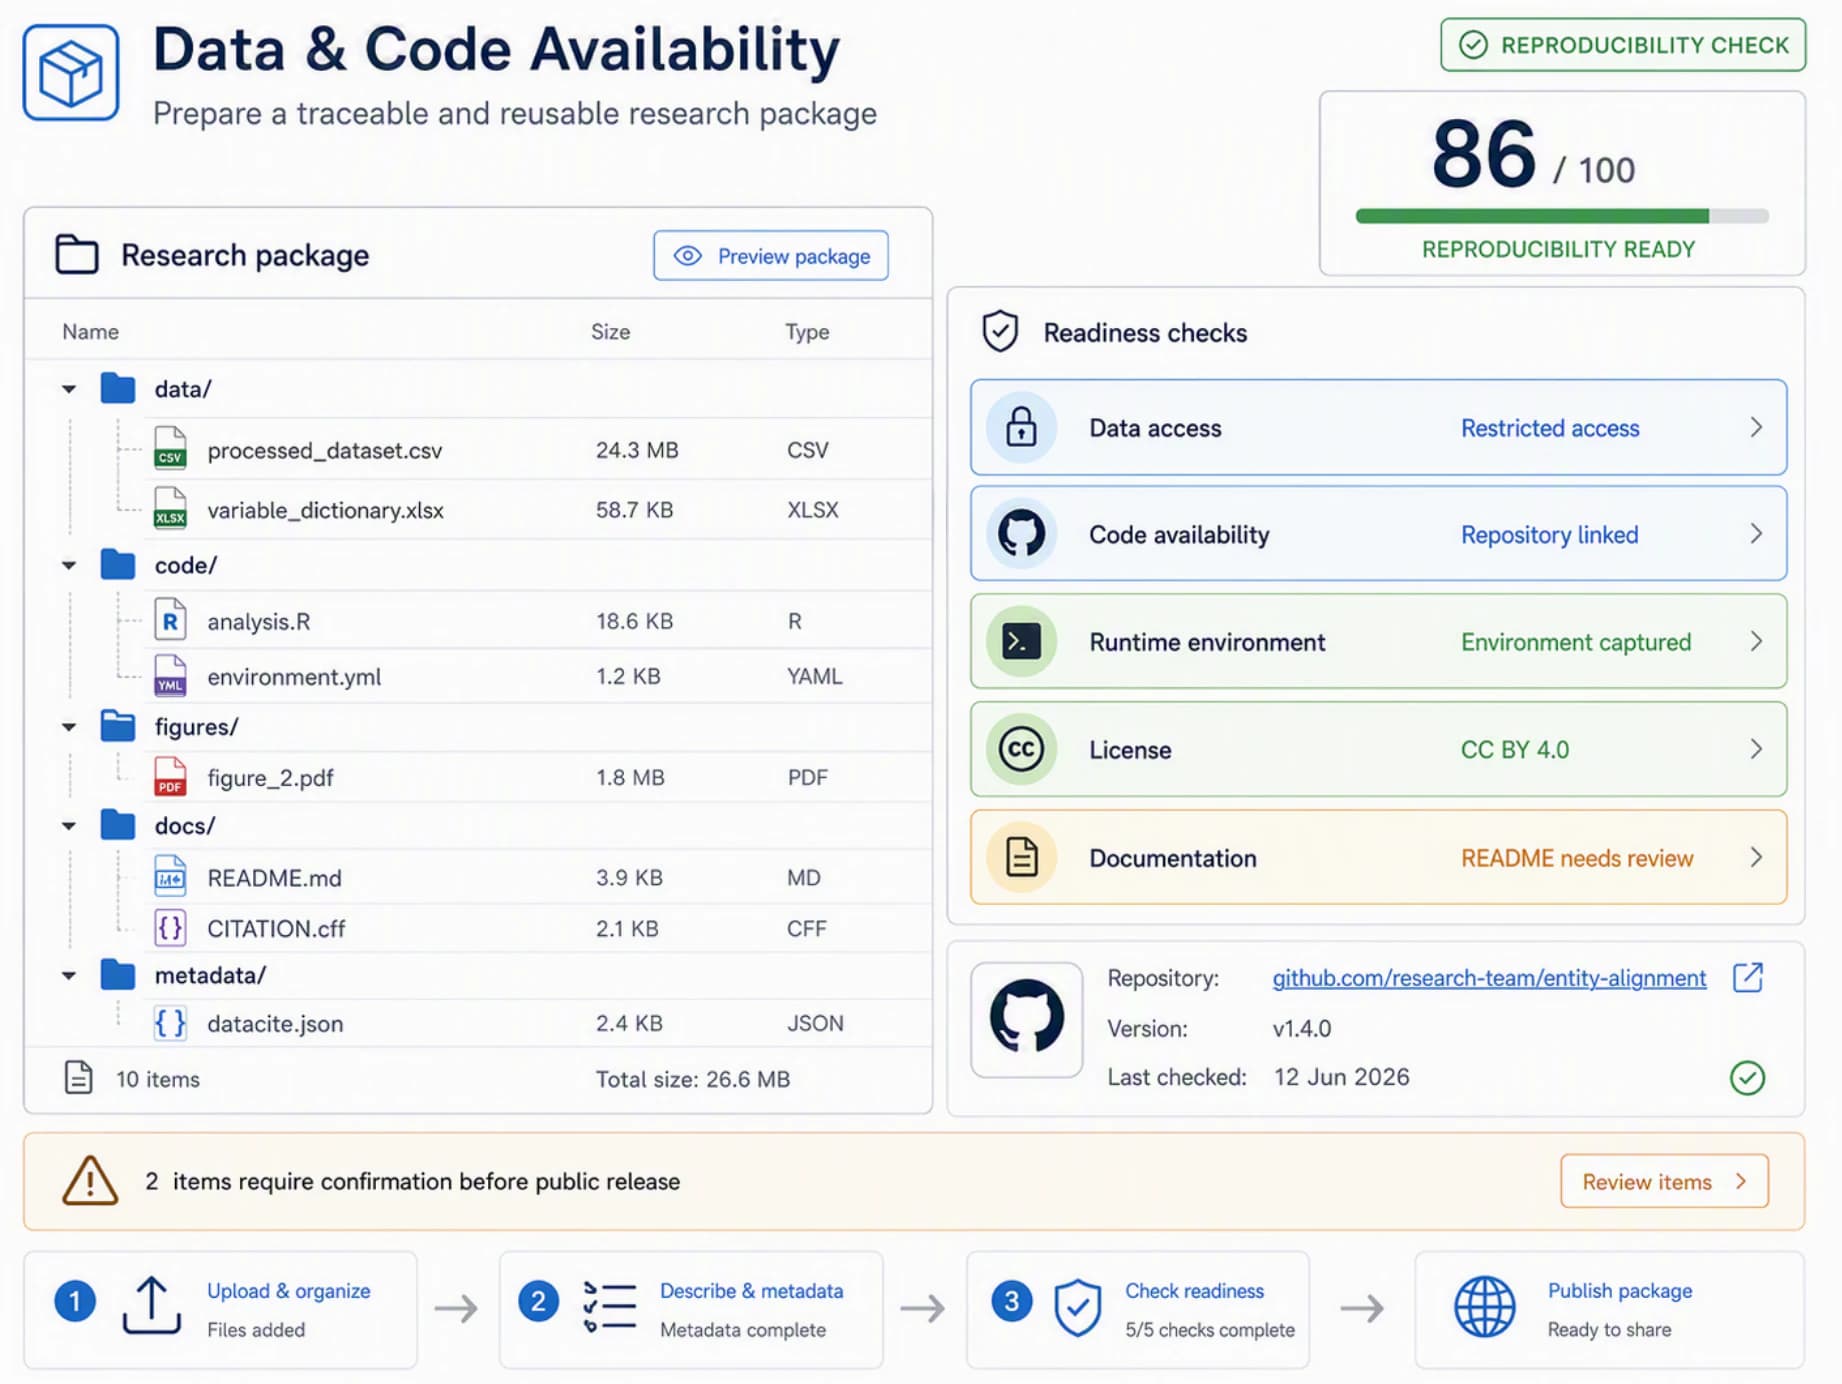
データ・コード公開の準備
再現可能なデータ・コードのパッケージと、投稿にそのまま使える利用可能性の記述を準備します。
活用例
準備済み:データと共有の状況
共有の目的
実行の流れ
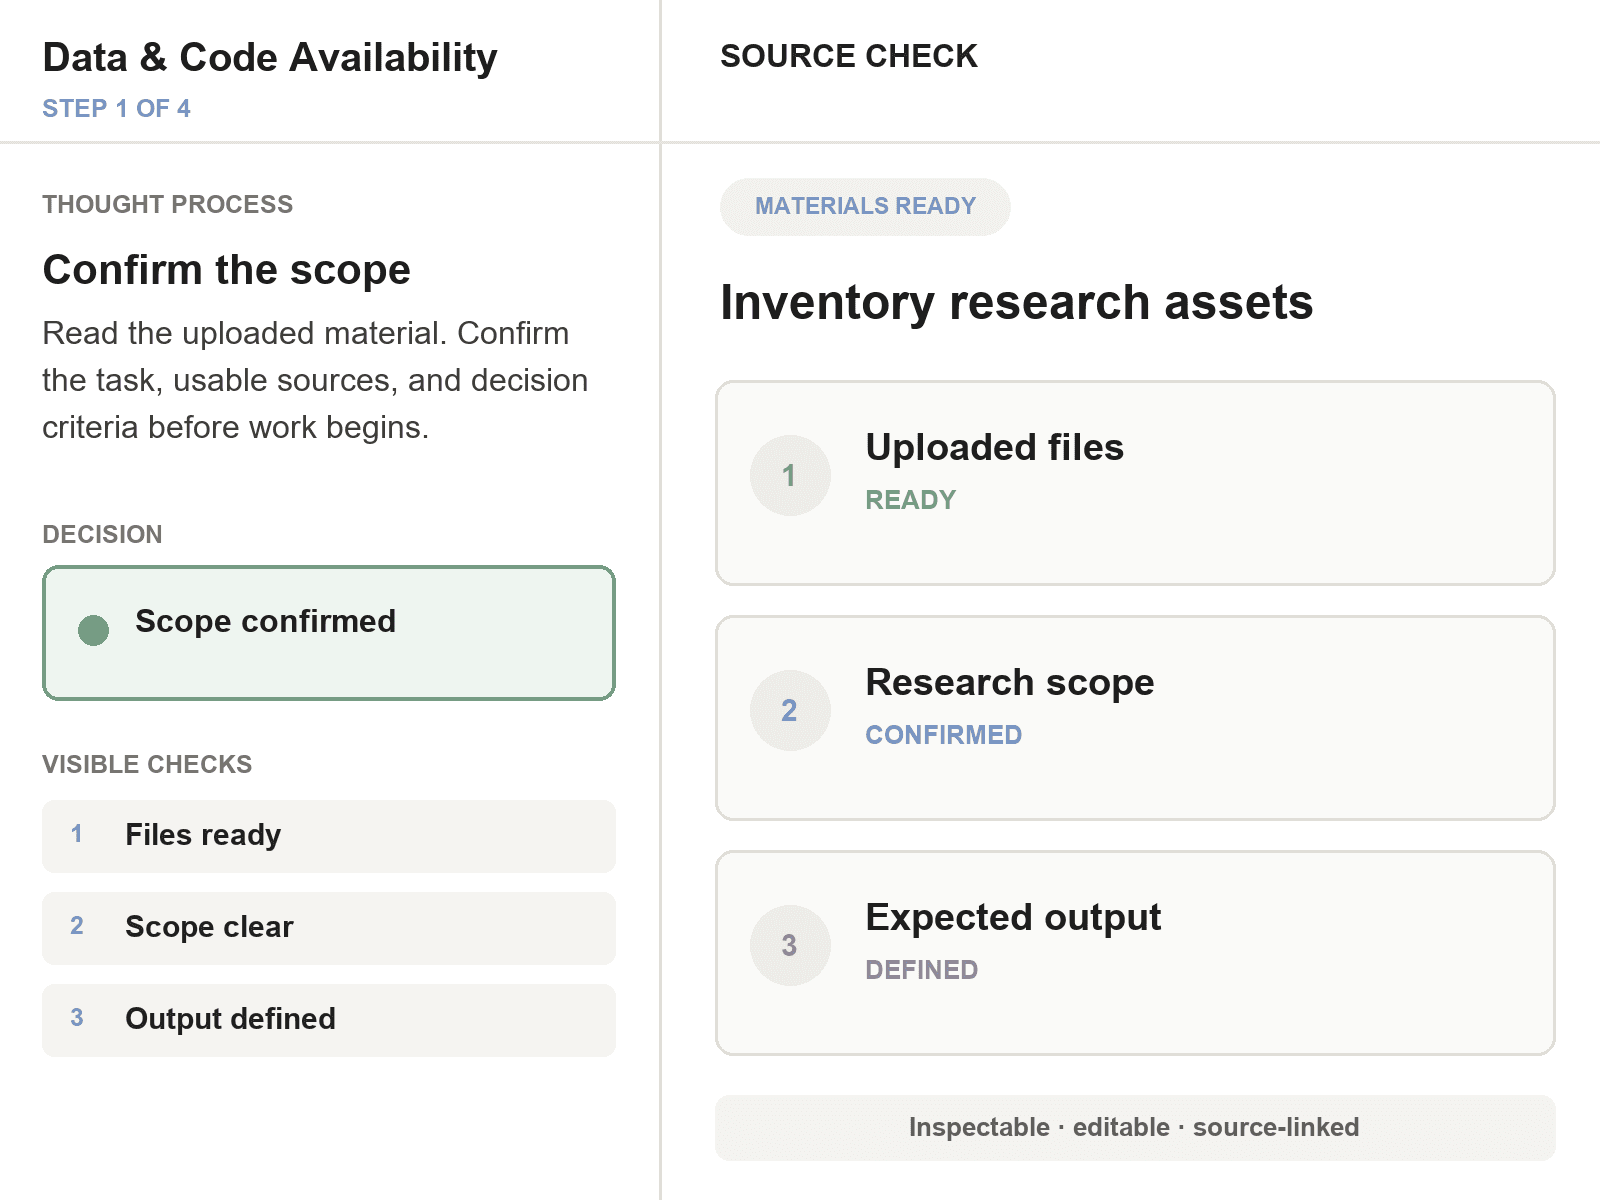
データとコードの棚卸し
結果を支えるすべてのデータセット、スクリプト、ノートブック、実行環境、モデル、アクセス上の制約を特定します。 本格的な作業に入る前に、範囲、使えるエビデンス、判断基準を確定し、後から生じうる不要な手戻りを減らします。
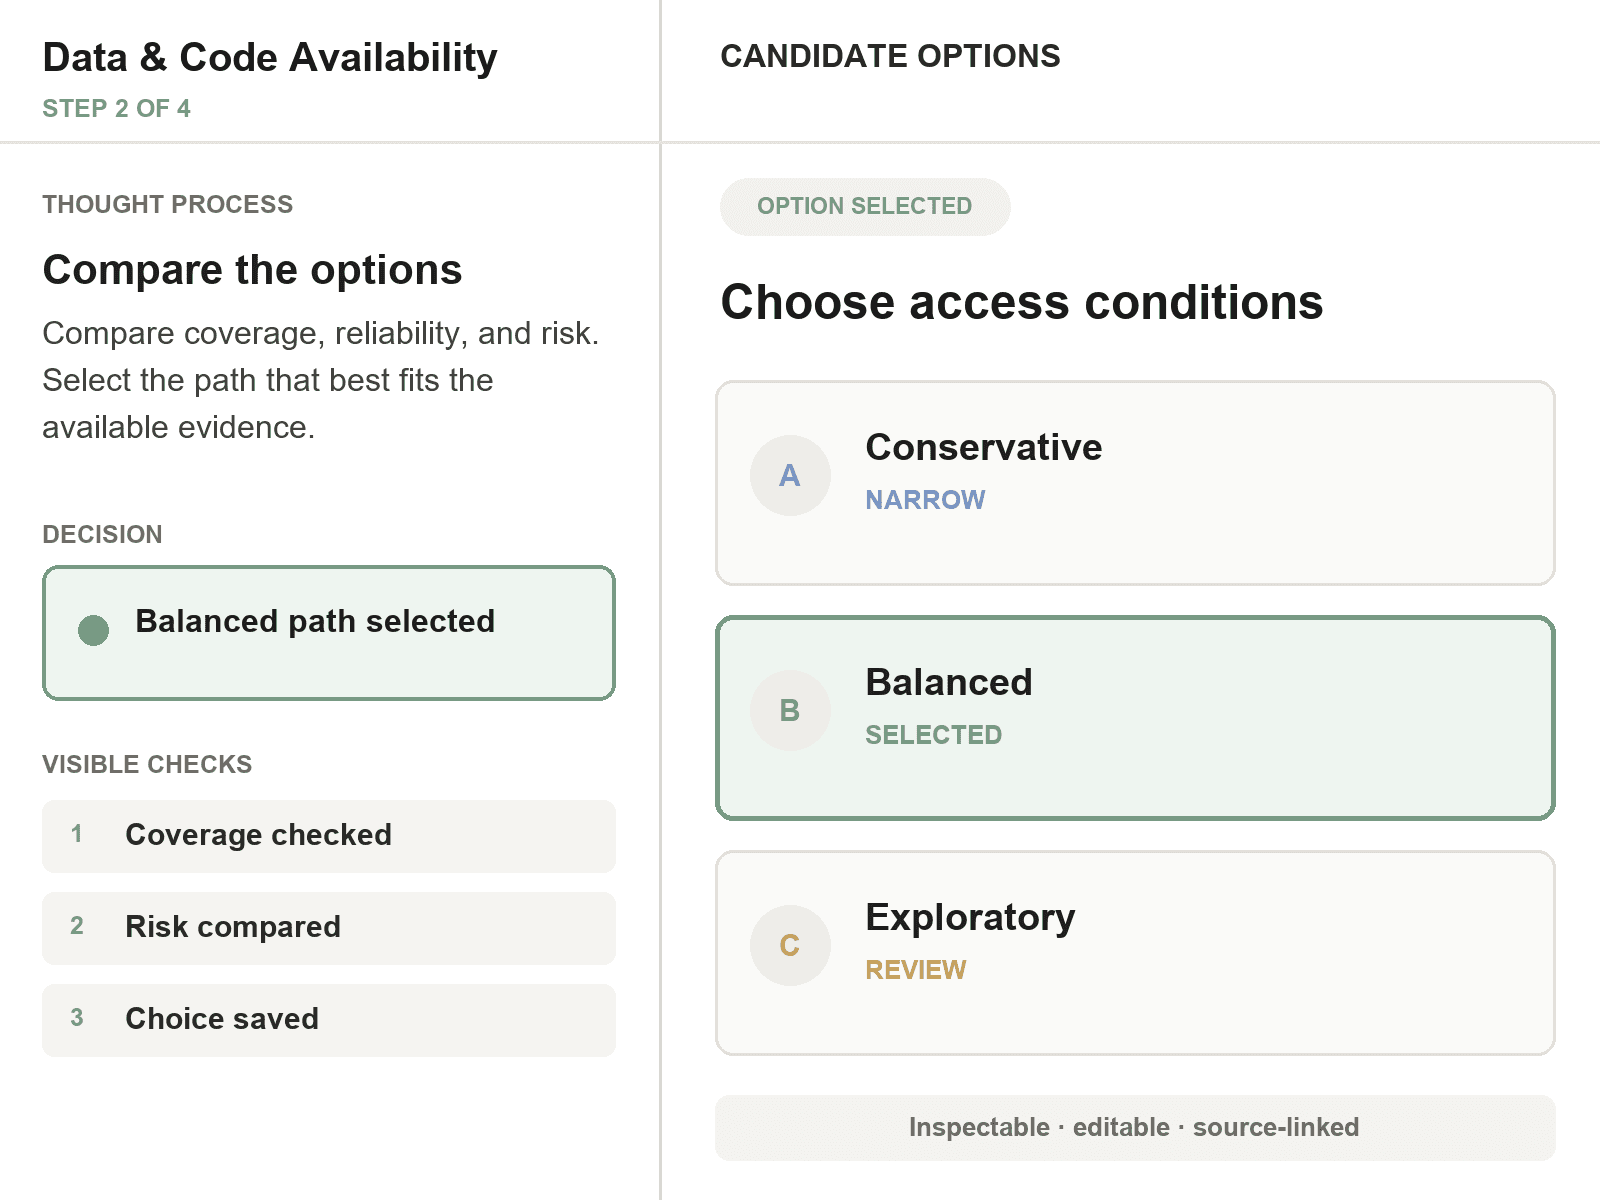
リポジトリと識別子の計画
リポジトリ、DOI やアクセッション番号、メタデータ、引用方法を提案します。 Yila は途中の判断、エビデンスの範囲、未解決の課題を見える状態に保つので、推論を確認し、必要に応じてワークフローの方向を修正できます。
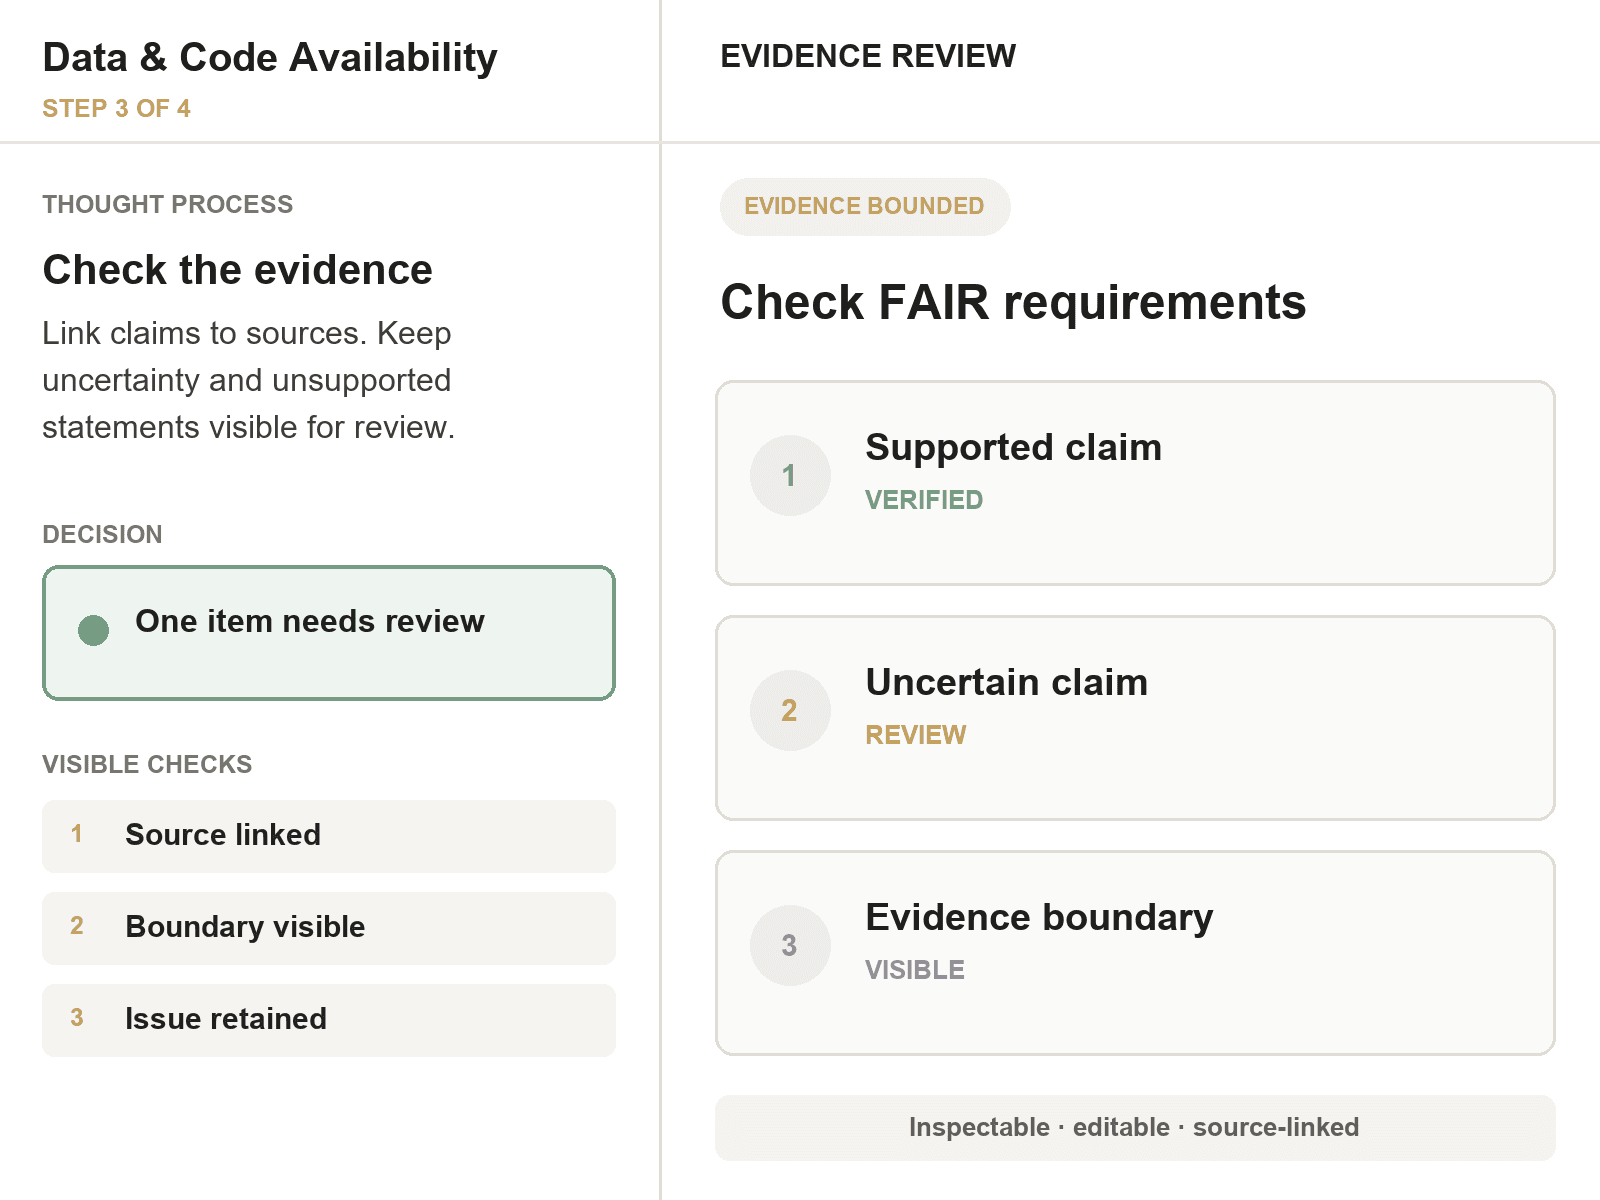
公開時の安全性の点検
メタデータ、ライセンス、実行環境の記録、プライバシー、秘密情報の露出を確認します。 Yila は途中の判断、エビデンスの範囲、未解決の課題を見える状態に保つので、推論を確認し、必要に応じてワークフローの方向を修正できます。
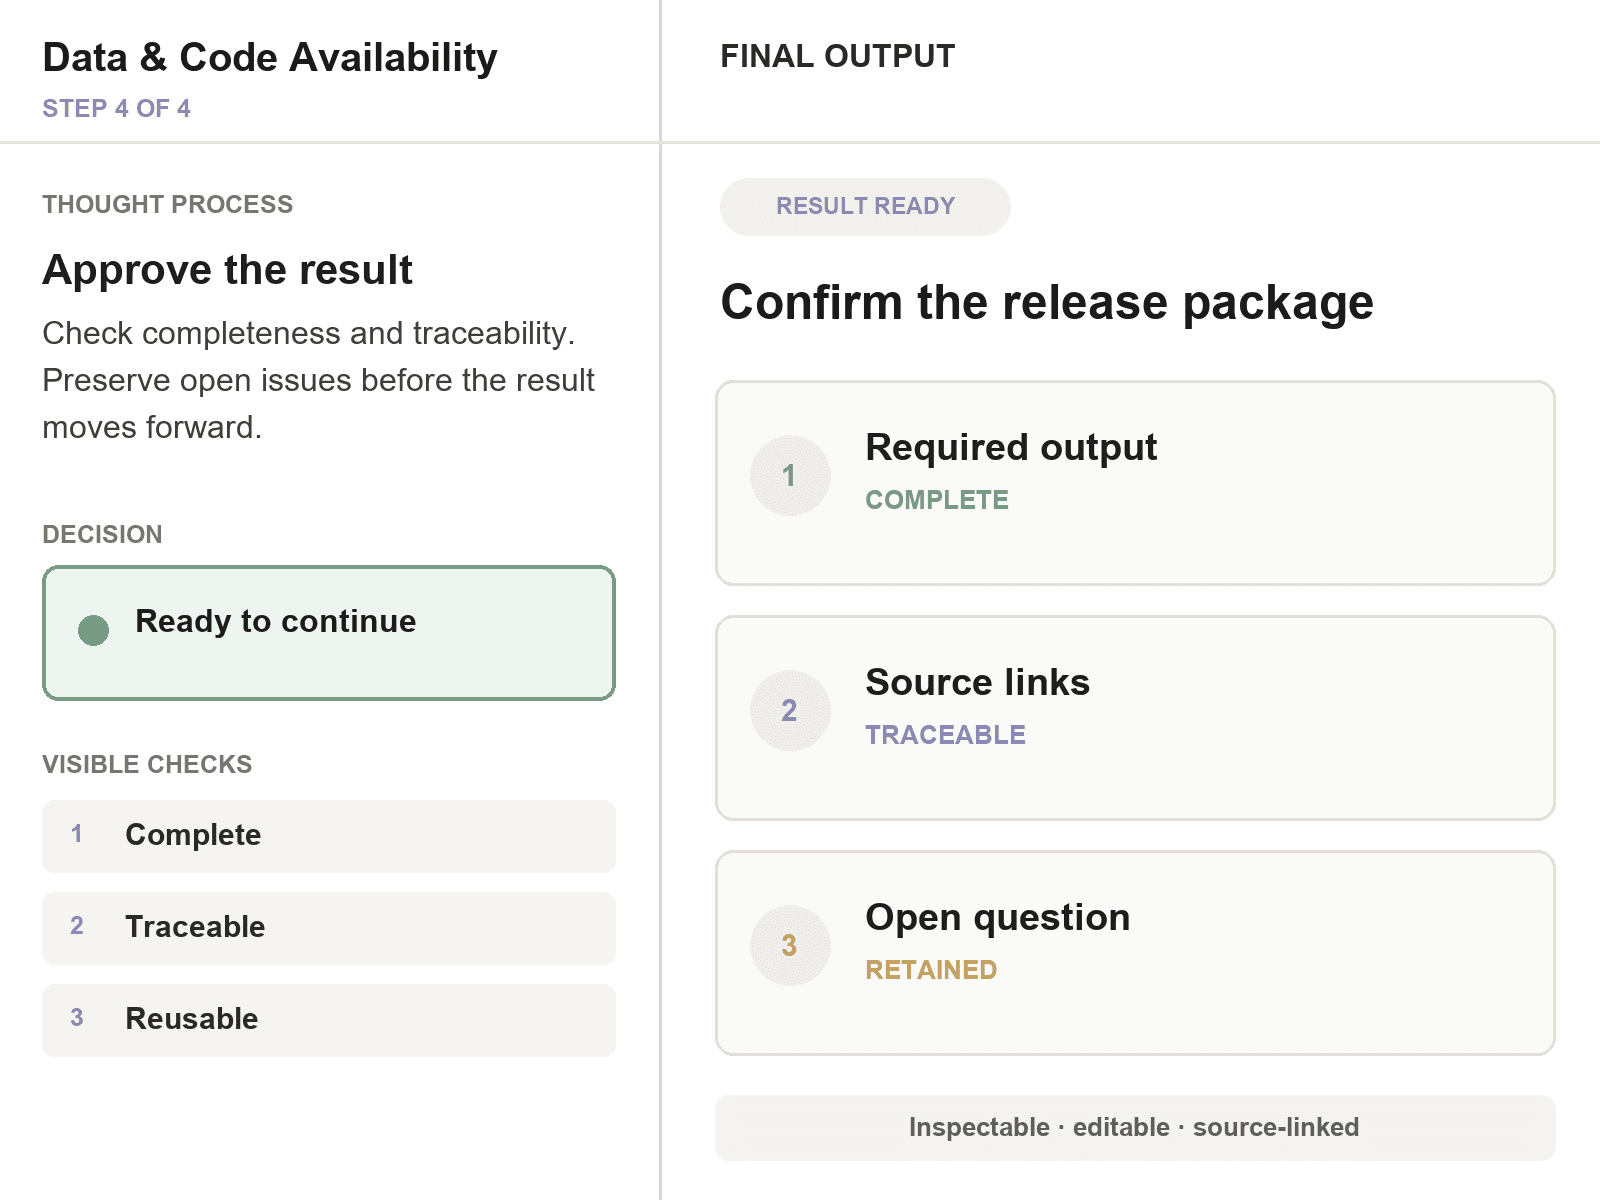
公開用パッケージの作成
そのまま貼り付けられる利用可能性の記述、公開用の README、FAIR・再現性の点検結果を作成します。 次の段階に進む前に、Yila は結果が完全で、出典をたどることができ、同じ研究の会話で次のステップを支えられる状態かを確認します。
よくある質問
研究を続ける
最初からやり直さずに、次の役立つステップへ進めます。
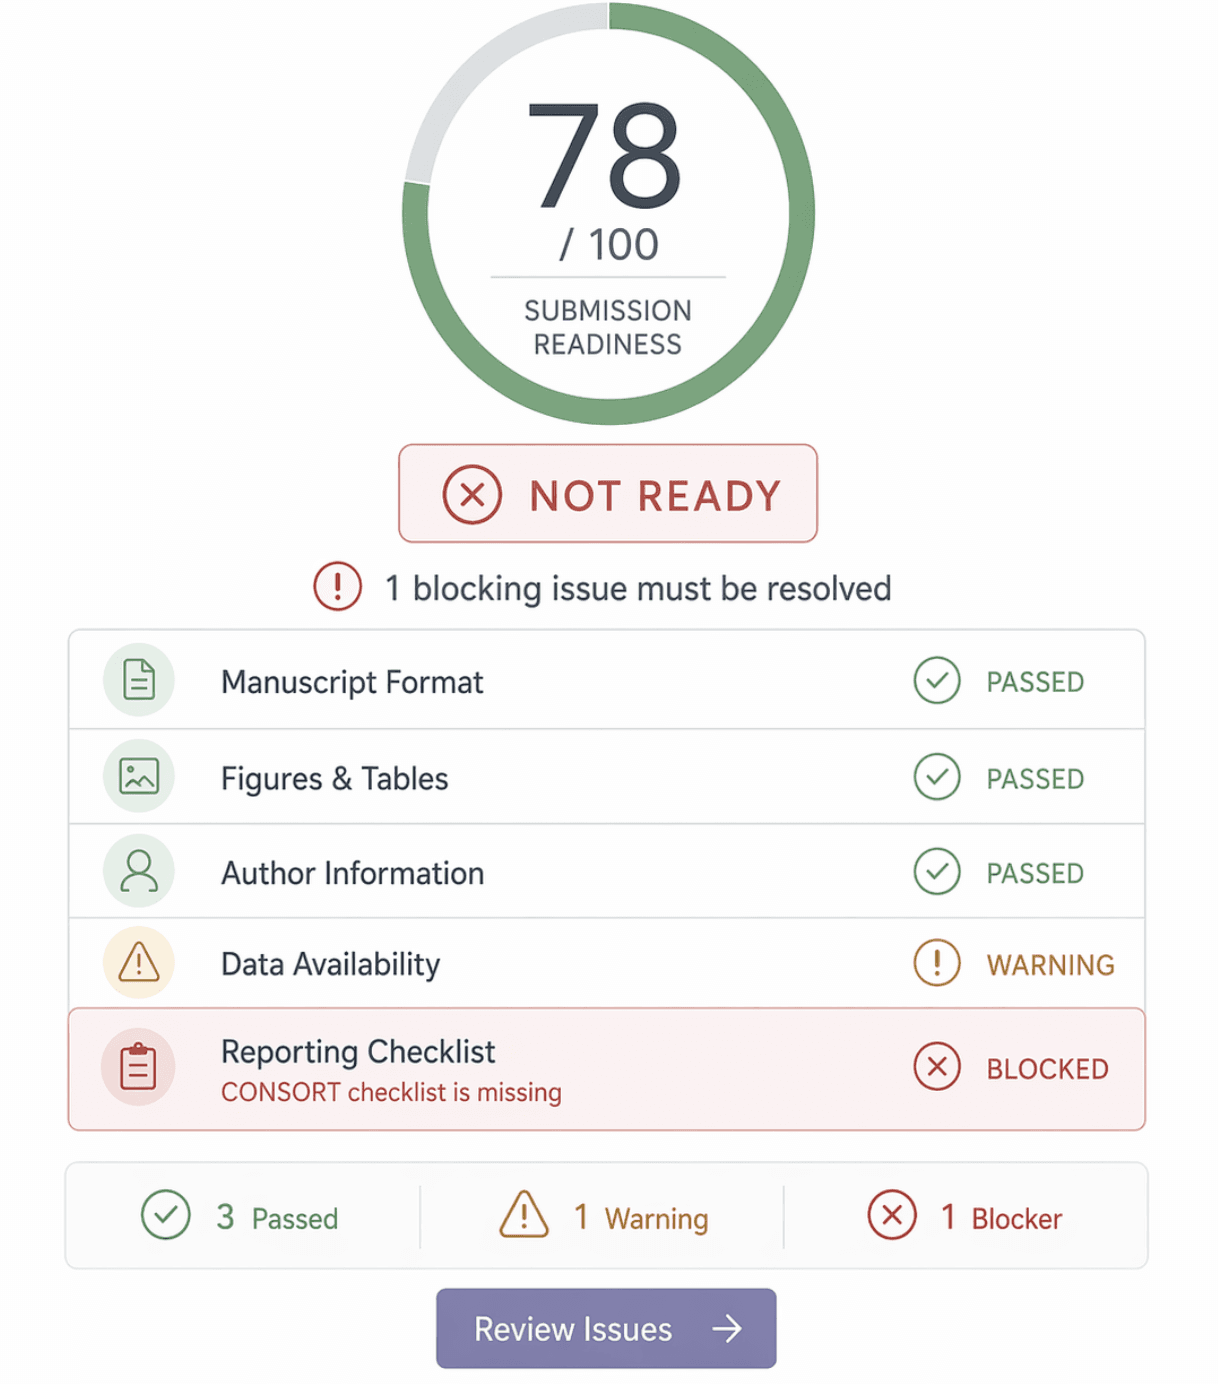
このワークフローを、ご自身の研究で試してみませんか?
Yila のワークベンチを開き、問いや資料を入力してください。Yila は同じ研究の会話の中で、選んだ方法に沿って作業を始めます。
この Playbook を実行